KI-Marketing-Wissensdatenbank: Die Wissensebene für verlässliche Workflows aufbauen
Eine KI-Marketing-Wissensdatenbank ist eine gesteuerte Sammlung freigegebenen Unternehmenswissens mit Metadaten, Zugriffsregeln, klaren Verantwortlichen und Abrufmechanismen, die Menschen und KI-gestützte Workflows gemeinsam nutzen.
Zusammenfassung für die Geschäftsleitung
Von KI-Systemen wird im Alltag erwartet, dass sie lückenhafte Dokumentation, widersprüchliche Fakten, schwer zugängliches Expertenwissen und unklare Zuständigkeiten ausgleichen. Doch Retrieval-Technologie kann Inhalte zutage fördern; sie kann nicht von selbst entscheiden, welche von mehreren widersprüchlichen Quellen ein Unternehmen tatsächlich als maßgeblich ansieht. Diese Entscheidung verlangt Governance. Ohne sie ist ein KI-gestützter Workflow nur so verlässlich wie das, was er gerade zufällig findet, und er kann eine kanonische Quelle nicht von einem veralteten Entwurf unterscheiden. Dieser Leitfaden behandelt das Knowledge Readiness Model, die Canonical Source Hierarchy, die Widersprüche zwischen Quellen auflöst, die Metadatenstruktur, die Wissen für Menschen und KI-Systeme gleichermaßen nutzbar macht, und den Umgang mit den Widersprüchen und Beleglücken, die unweigerlich auftauchen, sobald ein Unternehmen genauer hinsieht, was es eigentlich weiß.
Die wichtigsten Erkenntnisse:
- Die Qualität von KI-Output hängt nicht nur von der Modellqualität ab, sondern davon, ob das Unternehmen relevantes, zulässiges, aktuelles und maßgebliches Wissen in abrufbarer Form bereitstellen kann.
- Retrieval-Systeme fördern Inhalte zutage; ohne Governance entscheiden sie nicht, welche Quelle maßgeblich ist.
- Die Canonical Source Hierarchy reiht Quellen vom Source-of-Record bis zur veralteten Quelle (Deprecated Source), sodass Konflikte einen definierten Lösungsweg haben.
- Jedes Wissensobjekt braucht Metadaten (Verantwortliche, Status, Gültigkeitsdatum, Berechtigungen) und nicht nur Inhalt.
- Eine Wissensdatenbank, die keine Korrekturen und kein Feedback erhält, verschlechtert sich unbemerkt, auch wenn sie beim Start vollständig wirkte.
Was ist eine KI-Marketing-Wissensdatenbank?
Eine KI-Marketing-Wissensdatenbank ist gesteuertes Wissen und nicht bloß abgelegter Inhalt. Sie ist eine Sammlung freigegebener Unternehmensinformationen, strukturiert mit Metadaten zu Verantwortlichen, Status und Aktualität, geschützt durch Zugriffsregeln, die Vertraulichkeitsgrenzen achten, und verbunden mit einem Abrufmechanismus, über den Menschen wie KI-gestützte Workflows finden und prüfen können, was sie brauchen. Das Wort „gesteuert“ trägt in dieser Definition echtes Gewicht: Ein Ordner voller Dokumente ist keine Wissensdatenbank, solange niemand entschieden hat, was maßgeblich ist, wer für die Aktualität zuständig ist und wer was sehen darf.
Die meisten Unternehmen haben bereits etwas, das dem Rohmaterial einer Wissensdatenbank gleicht (ein gemeinsames Laufwerk, ein Wiki, ein CMS, verstreute Präsentationen), ohne die Governance-Arbeit geleistet zu haben, die aus diesem Material etwas macht, auf das sich ein KI-gestützter Workflow verlassen kann. Diese Lücke bleibt oft unsichtbar, bis ein KI-System mit voller Überzeugung eine Folie zitiert, die vor eineinhalb Jahren abgelöst wurde, weil nichts im Ablagesystem darauf hinwies. Die Technik hat in diesem Fall nicht versagt: Sie hat exakt das abgerufen, was dort lag. Das Wissen des Unternehmens war schlicht nicht gut genug gesteuert, um die Verlässlichkeit zu tragen, die der Workflow brauchte.
Wissensdatenbank, Dokumentenablage, Suchindex und RAG im Vergleich
Diese vier Begriffe werden oft durcheinandergeworfen, dabei entscheiden die Unterschiede darüber, was jeder davon tatsächlich leisten kann.
| Begriff | Was er leistet | Was ohne Governance fehlt |
|---|---|---|
| Dokumentenablage | Speicherort für Dateien | Keine Rangfolge der Maßgeblichkeit, kein Metadatenstandard, kein Aktualitätssignal |
| Suchindex | Auffindbarkeit gespeicherter Inhalte | Keine Unterscheidung zwischen maßgeblichen und veralteten Inhalten |
| RAG (Retrieval-Augmented Generation) | Ein technischer Mechanismus, der ein Modell zur Abfragezeit mit externen Inhalten verbindet | Kein eigenes Urteil darüber, welcher abgerufene Inhalt richtig oder aktuell ist |
| Gesteuerte Wissensdatenbank | Maßgebliche, berechtigungsgesteuerte, metadatenreiche Inhalte mit klar definierter Verantwortung | Nichts: Governance ist hier bereits Teil der Definition |
RAG wird besonders häufig mit einer Governance-Lösung verwechselt. Es ist ein Abrufmechanismus, und selbst ein gut umgesetzter kann nur abrufen, was tatsächlich vorhanden ist. Sind die zugrunde liegenden Inhalte widersprüchlich, veraltet oder unstrukturiert, ruft RAG widersprüchliche, veraltete oder unstrukturierte Inhalte genauso effizient ab wie verlässliche. Die Technik hat keine eigene Möglichkeit zu erkennen, was was ist.
Warum ein besseres Modell Unordnung im Wissen nicht behebt
Ein leistungsfähigeres Modell kann die Informationen, die es erhält, besser verarbeiten. Es kann aber kein Unternehmenswissen erfinden, das nicht existiert, und es kann nicht zuverlässig erkennen, welche von zwei widersprüchlichen internen Quellen die aktuelle Unternehmenslinie abbildet, wenn man es ihm nicht sagt. Manche Unternehmen reagieren auf unzuverlässigen KI-Output mit dem Umstieg auf ein neueres oder größeres Modell, obwohl der eigentliche Engpass die Qualität und Steuerung des Wissens ist, auf das dieses Modell zugreift. Kein Modell-Upgrade beantwortet die Frage, welche Quelle das Unternehmen als maßgeblich behandelt. Das ist eine Governance-Entscheidung und keine technische, und sie muss ausdrücklich getroffen werden.
Das lohnt sich deutlich auszusprechen, weil es einem verbreiteten und nachvollziehbaren Reflex widerspricht: Wenn KI-gestützter Output unzuverlässig ist, sucht man instinktiv nach einer technischen Lösung, einem besseren Modell, einem anderen Anbieter, einer ausgefeilteren Retrieval-Konfiguration. Manchmal ist das die richtige Diagnose. Führt die Unzuverlässigkeit aber auf widersprüchliche interne Quellen, fehlende Verantwortung oder veraltete Inhalte zurück, die mit derselben Sicherheit präsentiert werden wie aktuelle, behebt keine technische Änderung die eigentliche Ursache. Unternehmen, die ihre KI-Werkzeuge bei Wissensproblemen immer wieder austauschen, ohne je die Governance-Arbeit zu leisten, erleben meist, dass dieselbe Fehlerart mit jedem neuen Tool (auf Englisch) wiederkehrt, denn das Tool war nie die Quelle des Problems.
Knowledge Readiness Model
Das Knowledge Readiness Model von kōdōkalabs bewertet Unternehmenswissen anhand von acht Dimensionen, bevor es als reif gilt, KI-gestützte Workflows verlässlich zu tragen.
| Dimension | Was geprüft wird |
|---|---|
| Maßgeblichkeit | Ob klar ist, welche Quelle bei Widersprüchen die maßgebliche ist |
| Vollständigkeit | Ob Wissenslücken ausdrücklich identifiziert und nicht nur als nicht vorhanden angenommen wurden |
| Struktur | Ob das Wissen in einer Form organisiert ist, die ein Retrieval-System tatsächlich nutzen kann |
| Zugänglichkeit | Ob die Menschen und Systeme, die das Wissen brauchen, es tatsächlich erreichen |
| Aktualität | Ob das Wissen aktuell ist, mit definierten Prüfzyklen |
| Berechtigungen | Ob der Zugriff Vertraulichkeit und Kundengrenzen respektiert |
| Rückverfolgbarkeit | Ob sich ein Wissensstück auf seine Quelle und seine Freigabe zurückführen lässt |
| Feedback | Ob es einen Mechanismus gibt, Wissen im Lauf der Zeit zu korrigieren und zu verbessern |
Fehlen einem Workflow mehrere dieser Bausteine, ist er nicht in dem Sinn undokumentiert, dass es gar keine Dokumentation gäbe. Er ist so dokumentiert, dass bestimmte, vorhersehbare Lücken bleiben, und genau dort entstehen die Anfälligkeit bei Übergaben und die Schwierigkeiten bei der Fehlersuche.
Was in die Wissensebene des Marketings gehört
Zur Wissensebene des Marketings gehören typischerweise Markenrichtlinien und Stilvorgaben, Fakten zu Produkten und Leistungen, freigegebene Botschaften und Positionierung, Kunden- und Marktforschung, Leistungsdaten und Belege aus Fallbeispielen, rechtliche und Compliance-Vorgaben für Marketingaussagen sowie unternehmenseigene Terminologie und Definitionen des Frameworks. Nicht alles, was ein Unternehmen je geschrieben hat, gehört in diese Ebene. Ziel ist freigegebenes, aktuell relevantes Wissen, auf das sich Workflows verlassen können, und kein vollständiges Archiv sämtlicher je erstellter Dokumente. Zu unterscheiden zwischen „allem, was wir geschrieben haben“ und „dem, worauf wir uns heute stützen“, ist selbst eine Governance-Entscheidung und nicht nur eine Datenmigration.
Canonical Source Hierarchy
 KI-generiert Bild
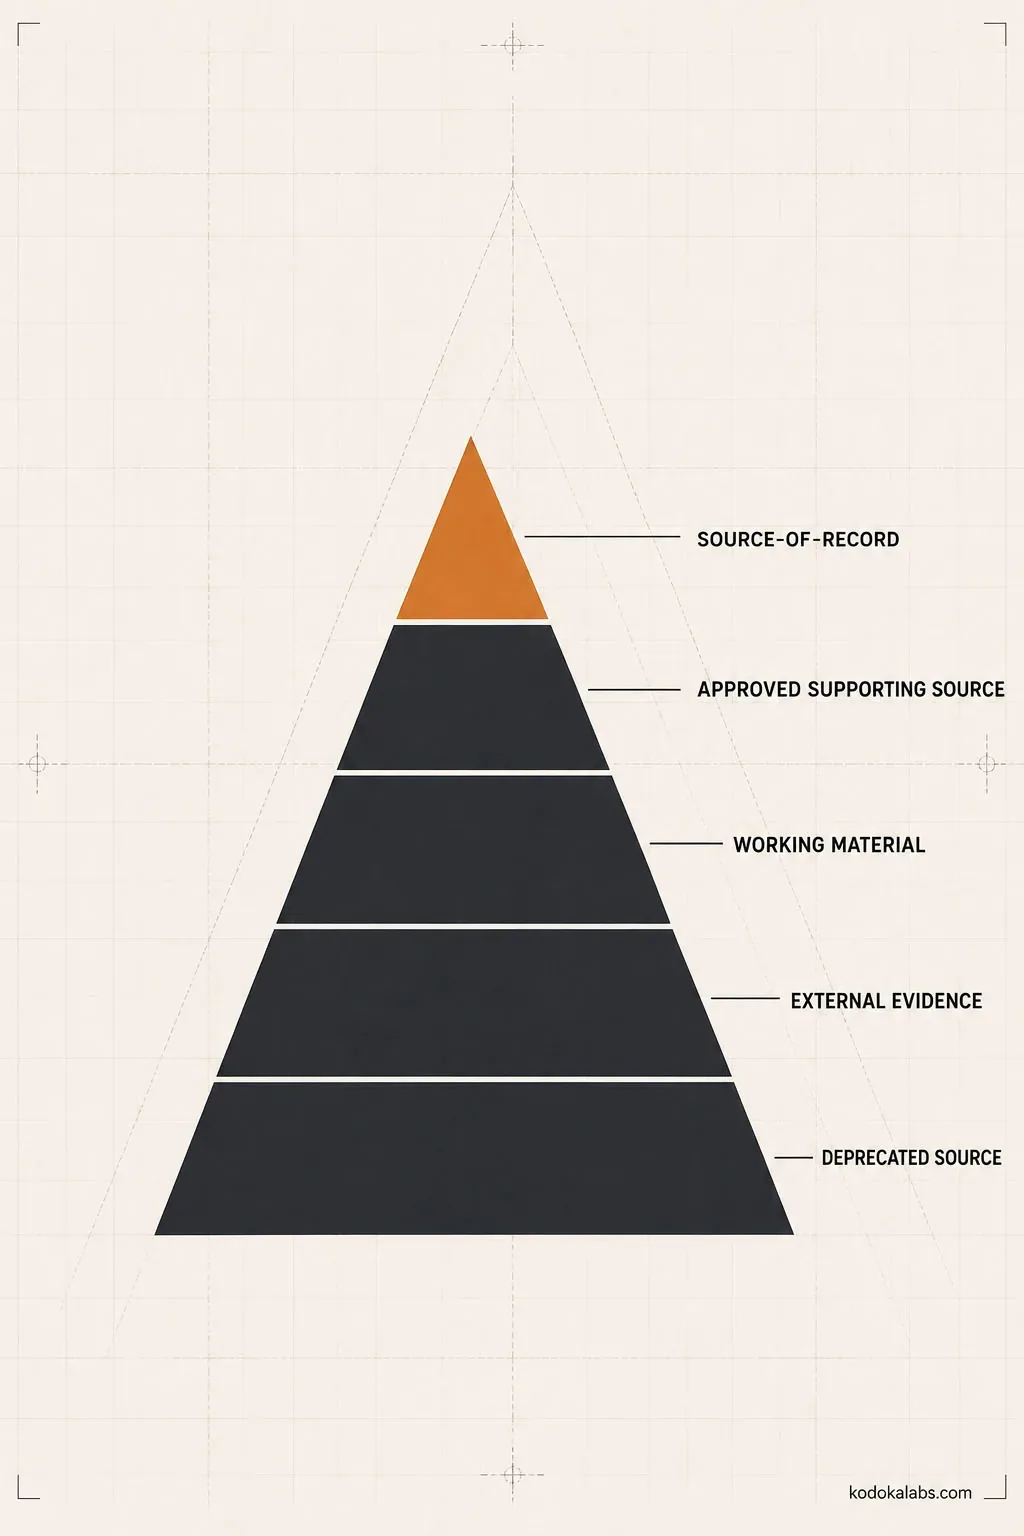
Die Canonical Source Hierarchy von kōdōkalabs reiht Wissen nach Maßgeblichkeit und gibt Workflows und Prüfenden einen festen Weg, Konflikte aufzulösen, statt zu raten.
| Rang | Quellenklasse | Beschreibung |
|---|---|---|
| 1 | Source-of-Record | Die einzige maßgebliche Fassung für einen bestimmten Sachverhalt |
| 2 | Freigegebene Ergänzungsquelle | Geprüftes, aktuelles Material, das die Source-of-Record stützt, sie aber nicht überstimmt |
| 3 | Arbeitsmaterial | Inhalte in Bearbeitung, noch nicht für die Verwendung freigegeben |
| 4 | Externe Belege | Forschung oder Daten Dritter, mit angemessener Quellenangabe und Aktualitätsprüfung verwendet |
| 5 | Veraltete Quelle (Deprecated Source) | Früher maßgebliches Material, ausdrücklich ausgemustert und als nicht mehr aktuell gekennzeichnet |
Widersprechen sich zwei Inhalte, entscheidet die Hierarchie darüber, welcher gilt, und nicht das Dokument, das ein Praktiker zufällig als Erstes findet. Eine veraltete Quelle, die nicht eindeutig als solche gekennzeichnet ist, ist ein häufiger und vermeidbarer Grund dafür, dass KI-gestützte Workflows mit voller Überzeugung überholte Informationen zitieren.
Wissensobjekte, Metadaten und Taxonomie
Jedes Stück Wissen in einer gesteuerten Wissensdatenbank ist ein Wissensobjekt mit strukturierten Metadaten und nicht nur roher Inhalt.
| Metadatenfeld | Zweck |
|---|---|
| Titel und eindeutige ID | Eindeutige Identifikation |
| Verantwortliche | Wer für die Richtigkeit dieses Objekts einsteht |
| Typ | Um welche Art von Wissen es sich handelt (Fakt, Richtlinie, Forschung, Regelwerk) |
| Zielgruppe | Für wen dieses Wissen gedacht ist |
| Quellenstatus | Wo es in der Canonical Source Hierarchy steht |
| Gültigkeits- und Prüfdatum | Wann es aktuell wurde und wann die nächste Prüfung ansteht |
| Region und Produkt bzw. Entität | Geltungsbereich |
| Berechtigungen | Wer darauf zugreifen darf |
| Quellenangaben | Worauf es beruht |
| Abhängigkeiten | Auf welche anderen Wissensobjekte es sich stützt oder auswirkt |
| Version | Aktuelle Revision |
| Ausmusterungsstatus | Ob es aktiv, in Prüfung oder veraltet ist |
Diese Metadaten machen aus einem Dokument etwas, über das ein Retrieval-System und ein menschlicher Prüfer gleichermaßen urteilen können. Ohne sie wirkt jeder Inhalt gleich aktuell und gleich maßgeblich, und das stimmt selten.
Verantwortung, Freigabe und Aktualität
Jedes Wissensobjekt braucht namentlich benannte Verantwortliche, die für seine Richtigkeit einstehen, einen Freigabenachweis, wer die aktuelle Fassung abgenommen hat, und einen festen Prüfrhythmus, der dazu passt, wie schnell sich diese Wissensart ändert: Preise und Produktspezifikationen müssen in der Regel häufiger geprüft werden als grundlegende Markenprinzipien. Wissen ohne Verantwortliche veraltet unbemerkt: Niemand ist dafür zuständig, es zu merken, also liegt es einfach da und untergräbt still die Verlässlichkeit von allem, was darauf aufbaut.
Zugriff, Vertraulichkeit und Kundengrenzen
Eine Marketing-Wissensdatenbank in einem Unternehmen mit mehreren Kunden oder mit wirklich vertraulichen internen Informationen braucht Zugriffsregeln, die diese Grenzen auf der Abrufebene einhalten, und nicht nur als Vorgabe, die irgendwo in einem Dokument steht. Workflows und KI-Systeme, die aus der Wissensdatenbank abrufen, müssen dieselben Berechtigungen beachten wie ein menschlicher Nutzer. Ein Workflow für einen Kunden darf keinen Abrufzugriff auf vertrauliches Material eines anderen Kunden haben, und rein interne Wissensbestände dürfen nicht für Systeme abrufbar sein, die extern sichtbare Ergebnisse erzeugen.
Abruf-Design und Quellenangabe
 KI-generiert Bild
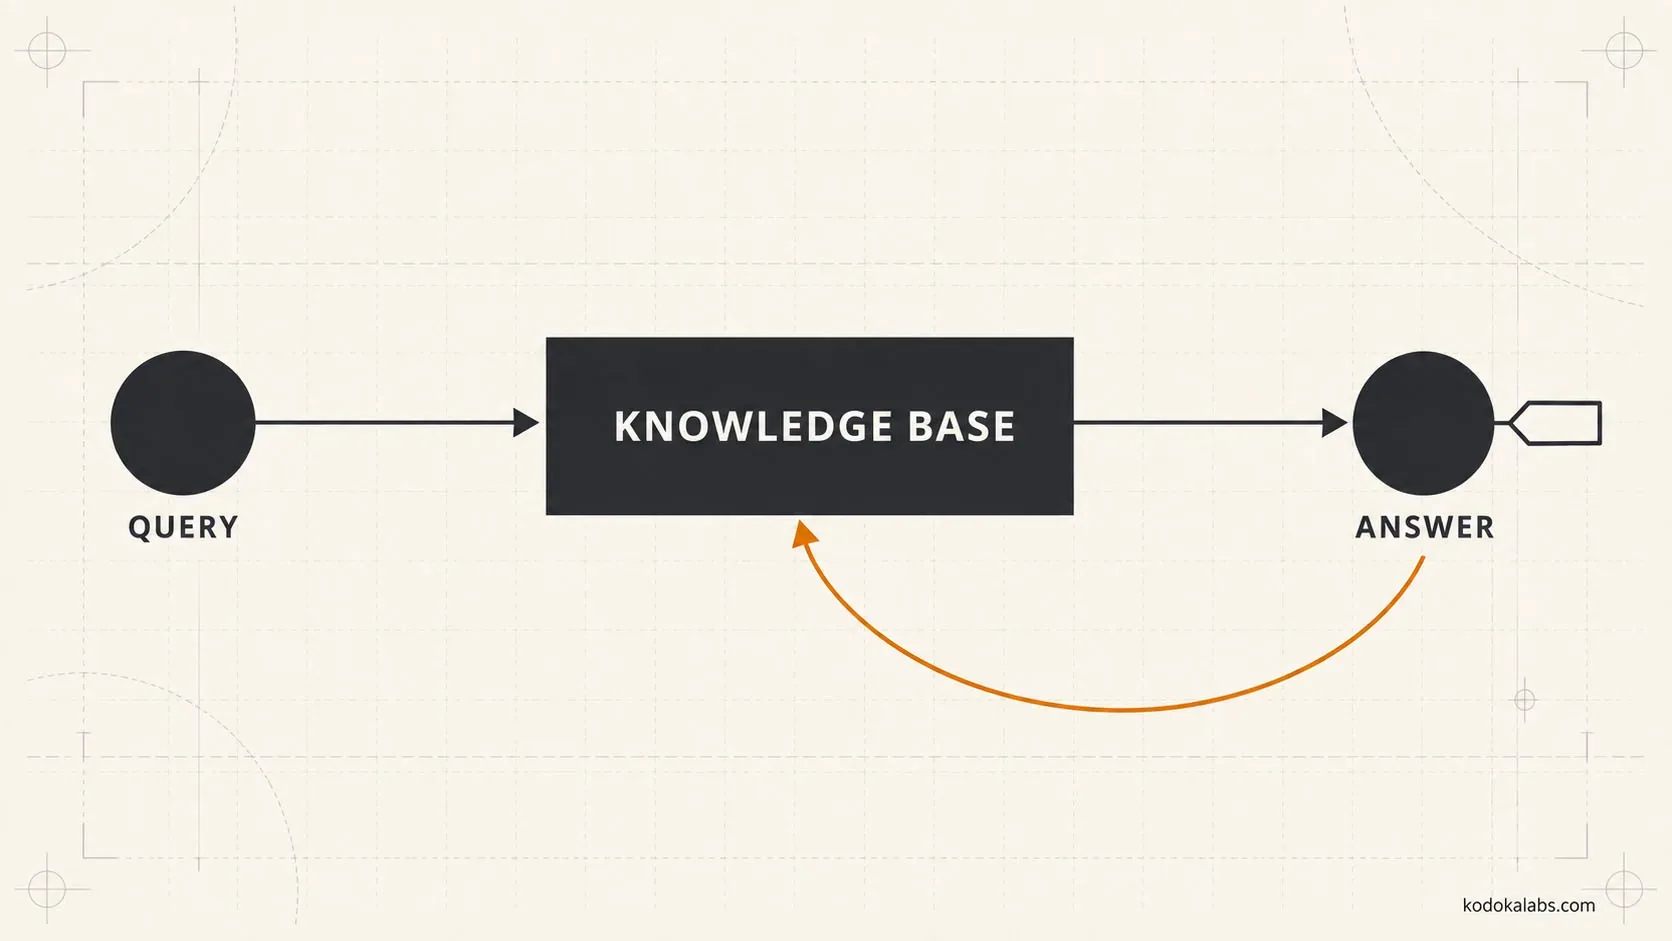
Ein gut gestaltetes Retrieval-System fördert nicht nur relevante Inhalte zutage. Es weist das Abgerufene seiner Quelle zu, sodass ein menschlicher Prüfer die Aussage verifizieren kann, statt der Zusammenfassung des KI-Systems blind zu vertrauen. Das Abruf-Design sollte die Rangfolge der Canonical Source Hierarchy beachten, Quellenstatus und Aktualität neben dem Inhalt selbst anzeigen und es einem Workflow leicht machen zu melden, dass nichts ausreichend Maßgebliches gefunden wurde. Ein ehrliches „keine verlässliche Quelle verfügbar“ ist nützlicher als eine selbstsichere Antwort auf Grundlage einer veralteten oder wenig maßgeblichen Quelle.
Umgang mit Widersprüchen und Beleglücken
Widersprüche zwischen Quellen und Lücken, in denen es kein freigegebenes Wissen gibt, sind in jeder echten Wissensdatenbank normale Funde. Entscheidend ist, ob das Unternehmen dafür einen festgelegten Prozess hat oder sie als unberechenbaren KI-Output zutage treten lässt. Ein Widerspruch gehört zur Klärung mit Hilfe der Canonical Source Hierarchy zu den Verantwortlichen der betroffenen Objekte. Eine echte Lücke gehört protokolliert und markiert und darf nicht stillschweigend durch die beste Vermutung eines KI-Systems gefüllt werden. Workflows, die melden „Dafür haben wir keine freigegebene Quelle“, schaffen mehr echten Wert als solche, die immer eine überzeugend klingende Antwort liefern, ganz gleich, ob das zugrunde liegende Wissen sie trägt.
Diese Vorliebe für ehrliche Lücken statt selbstsicherer Vermutungen läuft einem natürlichen Sog entgegen. Ein Workflow, der gelegentlich sagt „Dazu habe ich keine verlässliche Quelle“, wirkt weniger beeindruckend als einer, der stets eine runde, vollständig klingende Antwort liefert, und oft gibt es im Unternehmen Druck, Systeme in Richtung des eindrucksvolleren Verhaltens zu konfigurieren. Diesem Sog zu widerstehen, ist eine der wichtigeren und zugleich unbequemeren Governance-Entscheidungen der Verantwortlichen für eine Wissensdatenbank. Eine falsche, aber selbstsichere Antwort richtet in der Regel mehr Schaden an als eine ehrlich markierte Lücke: Der falschen Antwort wird vertraut und gehandelt, während die markierte Lücke wenigstens jemanden dazu bringt, die richtige Antwort zu suchen, bevor es weitergeht.
Erfassung von Expertenwissen
Ein erheblicher Teil des wertvollsten Wissens eines Unternehmens steckt nur in den Köpfen einzelner erfahrener Personen: im Kopf der Kundenbetreuerin, die weiß, warum eine bestimmte Kundenbeziehung behutsam behandelt werden muss, oder des Produktspezialisten, der einen nie aufgeschriebenen Sonderfall kennt. Dieses Wissen gezielt zu erfassen, durch strukturierte Interviews, die Auswertung früherer Entscheidungen oder Dokumentationsübungen, die in den normalen Arbeitsablauf eingebaut sind, verhindert, dass eine Wissensdatenbank auf das beschränkt bleibt, was ohnehin schon aufgeschrieben war. Diese Erfassung sollte geplant und mit Ressourcen hinterlegt sein und nicht nebenbei geschehen, wenn gerade jemand Zeit hat.
Feedback, Korrektur und Ausmusterung
Eine Wissensdatenbank braucht einen aktiven Feedbackkreislauf: eine Möglichkeit für alle, die auf einen Fehler, eine überholte Angabe oder eine Lücke stoßen, dies zu melden, und einen festgelegten Prozess, das betroffene Objekt zu korrigieren oder auszumustern. Ohne diesen Kreislauf verschlechtert sich eine Wissensdatenbank, die beim Start korrekt war, unbemerkt, während sich das Geschäft verändert (Preise ändern sich, Produkte laufen aus, die Positionierung verschiebt sich) und nichts in der Wissensdatenbank diese Änderungen abbildet, wenn sie niemand aktiv pflegt. Die Ausmusterung sollte ausdrücklich erfolgen und nicht bloß als Löschung. Eine früher maßgebliche Quelle, die stillschweigend entfernt wird, hinterlässt Lücken, die schwerer zu bemerken sind als eine eindeutig als ausgemustert gekennzeichnete.
Die Gesundheit der Wissensdatenbank messen
Die Gesundheit einer Wissensdatenbank lässt sich an mehreren Signalen messen: dem Anteil der Objekte mit überfälliger Prüfung, der Häufigkeit von Widersprüchen, die bei der Nutzung auffallen, der Rate gemeldeter Fehler und der Schnelligkeit ihrer Korrektur, der Abruferfolgsquote (wie oft ein Workflow eine ausreichend maßgebliche Quelle findet) und den Abdeckungslücken, die sich in der tatsächlichen Nutzung zeigen, statt als vollständig vorausgesetzt zu werden. Wer diese Größen als laufende Betriebskennzahlen behandelt und regelmäßig prüft, erkennt die Verschlechterung, bevor sie als unzuverlässiger KI-gestützter Output sichtbar wird und das Vertrauen in das gesamte System untergräbt.
Roadmap zur Umsetzung
Eine gesteuerte Wissensdatenbank von Grund auf aufzubauen, ist selten ein einzelnes Projekt. Eine praktische Reihenfolge beginnt damit, vorhandene Quellen zu identifizieren und mit der Canonical Source Hierarchy zu reihen. Danach folgen das Metadatenschema und seine Anwendung zuerst auf die Wissensobjekte mit höchster Priorität, dann Verantwortlichkeiten und Prüfrhythmen, dann die Anbindung des Abrufs für einen begrenzten Pilot-Workflow, und erst danach die Ausweitung von Abdeckung und Zugriff, sobald sich das Governance-Modell bewährt. Wer das gesamte Wissen eines Unternehmens migrieren und strukturieren will, bevor ein Workflow es nutzen kann, verzögert den Nutzen in der Regel endlos. Besser ist es, mit dem Wissen zu beginnen, das ein bestimmter Pilot-Workflow tatsächlich braucht, und es gut zu machen: So wachsen das Governance-Modell und die Akzeptanz im Unternehmen, von denen aus man erweitern kann.
Typische Fehlerbilder
- Abruf mit Governance verwechseln: Man nimmt an, eine RAG-Umsetzung löse die Wissensqualität von allein, ohne zu klären, was tatsächlich abgerufen wird.
- Keine Rangfolge der Maßgeblichkeit: Inhalte sind technisch durchsuchbar, aber es gibt keinen Hinweis darauf, welche Fassung bei widersprüchlichen Quellen aktuell ist.
- Wissen ohne Verantwortliche: Objekte ohne zuständige Person veralten unbemerkt.
- Vertraulichkeitslecks: Retrieval-Systeme beachten nicht dieselben Zugriffsgrenzen wie ein menschlicher Nutzer.
- Stilles Auffüllen von Lücken: Ein KI-System liefert eine selbstsichere Antwort, wo es gar keine maßgebliche Quelle gibt, statt die Lücke zu melden.
- Wissensprojekte mit Enddatum: Der Aufbau der Wissensdatenbank gilt als Projekt mit Abschlusstermin statt als laufende operative Disziplin.
- Löschen statt Ausmustern: Veraltete Inhalte werden entfernt, ohne festzuhalten, was ausgemustert wurde und warum.
Checkliste zur Wissensreife
Bevor man sich darauf verlässt, dass eine Wissensdatenbank KI-gestützte Marketing-Workflows trägt, sollte bestätigt sein: Quellen sind mit der Canonical Source Hierarchy gereiht. Jedes Wissensobjekt trägt vollständige Metadaten. Verantwortliche sind benannt und Prüfrhythmen festgelegt. Der Zugriff respektiert Vertraulichkeit und Kundengrenzen. Der Abruf weist Inhalte ihrer Quelle zu. Es gibt einen Prozess für Widersprüche und Lücken. Die Erfassung von Expertenwissen ist geplant und nicht zufällig. Ein Feedback- und Korrekturkreislauf ist aktiv. Und die Gesundheit der Wissensdatenbank wird laufend gemessen.
Häufig gestellte Fragen
Was macht eine Marketing-Wissensdatenbank „KI-tauglich“?
Governance: Rangfolge der Maßgeblichkeit über die Canonical Source Hierarchy, strukturierte Metadaten an jedem Objekt, definierte Verantwortung und Aktualitätszyklen sowie Zugriffskontrollen, die Vertraulichkeit achten. Ein Abrufmechanismus wie RAG allein genügt nicht.
Worin unterscheidet sich eine Wissensdatenbank von einer Dokumentenablage oder einem Suchindex?
Eine Ablage speichert Dateien und ein Suchindex macht sie auffindbar. Doch keines von beiden unterscheidet von sich aus zwischen maßgeblichen, aktuellen Inhalten und veraltetem oder widersprüchlichem Material. Siehe die Vergleichstabelle oben.
Lässt sich unorganisiertes Wissen durch ein besseres KI-Modell ausgleichen?
Nein. Ein leistungsfähigeres Modell kann die Informationen, die es erhält, besser verarbeiten, aber es kann fehlendes Unternehmenswissen nicht erfinden und nicht zuverlässig entscheiden, welche von zwei widersprüchlichen Quellen aktuell ist, wenn man es ihm nicht sagt.
Was ist die Canonical Source Hierarchy, und wie wendet man sie an?
Eine Rangfolge in fünf Stufen (Source-of-Record, freigegebene Ergänzungsquelle, Arbeitsmaterial, externe Belege, veraltete Quelle), die Workflows einen festgelegten Weg gibt, widersprüchliche Informationen aufzulösen.
Welche Metadaten braucht jedes Wissensobjekt?
Mindestens: Titel, ID, Verantwortliche, Typ, Zielgruppe, Quellenstatus, Gültigkeits- und Prüfdatum, Geltungsbereich, Berechtigungen, Quellenangaben, Abhängigkeiten, Version und Ausmusterungsstatus.
Wie geht man beim Abruf mit Vertraulichkeit und Kundengrenzen um?
Retrieval-Systeme sollten dieselben Zugriffsrechte beachten wie ein menschlicher Nutzer: Ein Workflow darf keine Inhalte abrufen, die er nicht sehen dürfte, wenn eine Person sie direkt anfordern würde.
Garantiert Retrieval-Augmented Generation, dass Antworten sachlich richtig sind?
Nein. Der Abruf fördert nur zutage, was tatsächlich in der Wissensdatenbank steht. Sind die zugrunde liegenden Inhalte veraltet, widersprüchlich oder unstrukturiert, liefert der Abruf diese unzuverlässigen Inhalte genauso bereitwillig wie verlässliche.
Was tun, wenn sich Ihre Quellen widersprechen?
Der Widerspruch geht mit Hilfe der Canonical Source Hierarchy zur Klärung an die zuständigen Objektverantwortlichen. Man überlässt ihn weder einem KI-System zur eigenen Entscheidung noch lässt man einen Workflow ihn uneinheitlich zutage fördern.
Wie erfasst man Expertenwissen, das nie aufgeschrieben wurde?
Durch gezielte, mit Ressourcen hinterlegte Erfassung: strukturierte Interviews, Auswertung früherer Entscheidungen, in normale Workflows eingebaute Dokumentation. Man wartet nicht darauf, dass es nebenbei aufgeschrieben wird.
Wie misst man die Gesundheit der Wissensdatenbank?
Über Signale wie den Anteil überfälliger Prüfungen, die Häufigkeit auftretender Widersprüche, die Dauer bis zur Fehlerkorrektur, die Abruferfolgsquote und Abdeckungslücken, die sich in der tatsächlichen Nutzung zeigen.
Fazit
Eine gesteuerte Wissensdatenbank ist die Ebene, die jede andere Fähigkeit im Cluster AI Marketing Operating Systems (Prompt-Architektur, Multi-Agenten-Koordination, Content-Qualitätskontrolle) erst wirklich verlässlich macht, denn alle hängen davon ab, dass das Wissen, aus dem diese Systeme schöpfen, aktuell, maßgeblich und rückverfolgbar ist. Unternehmen, die in Workflow-Design und Werkzeuge investieren, ihr zugrunde liegendes Wissen aber ungesteuert lassen, stellen meist fest, dass keine noch so gute Verbesserung der nachgelagerten Prozesse eine unzuverlässige Wissensebene ausgleicht.