Definición, riesgo y controles
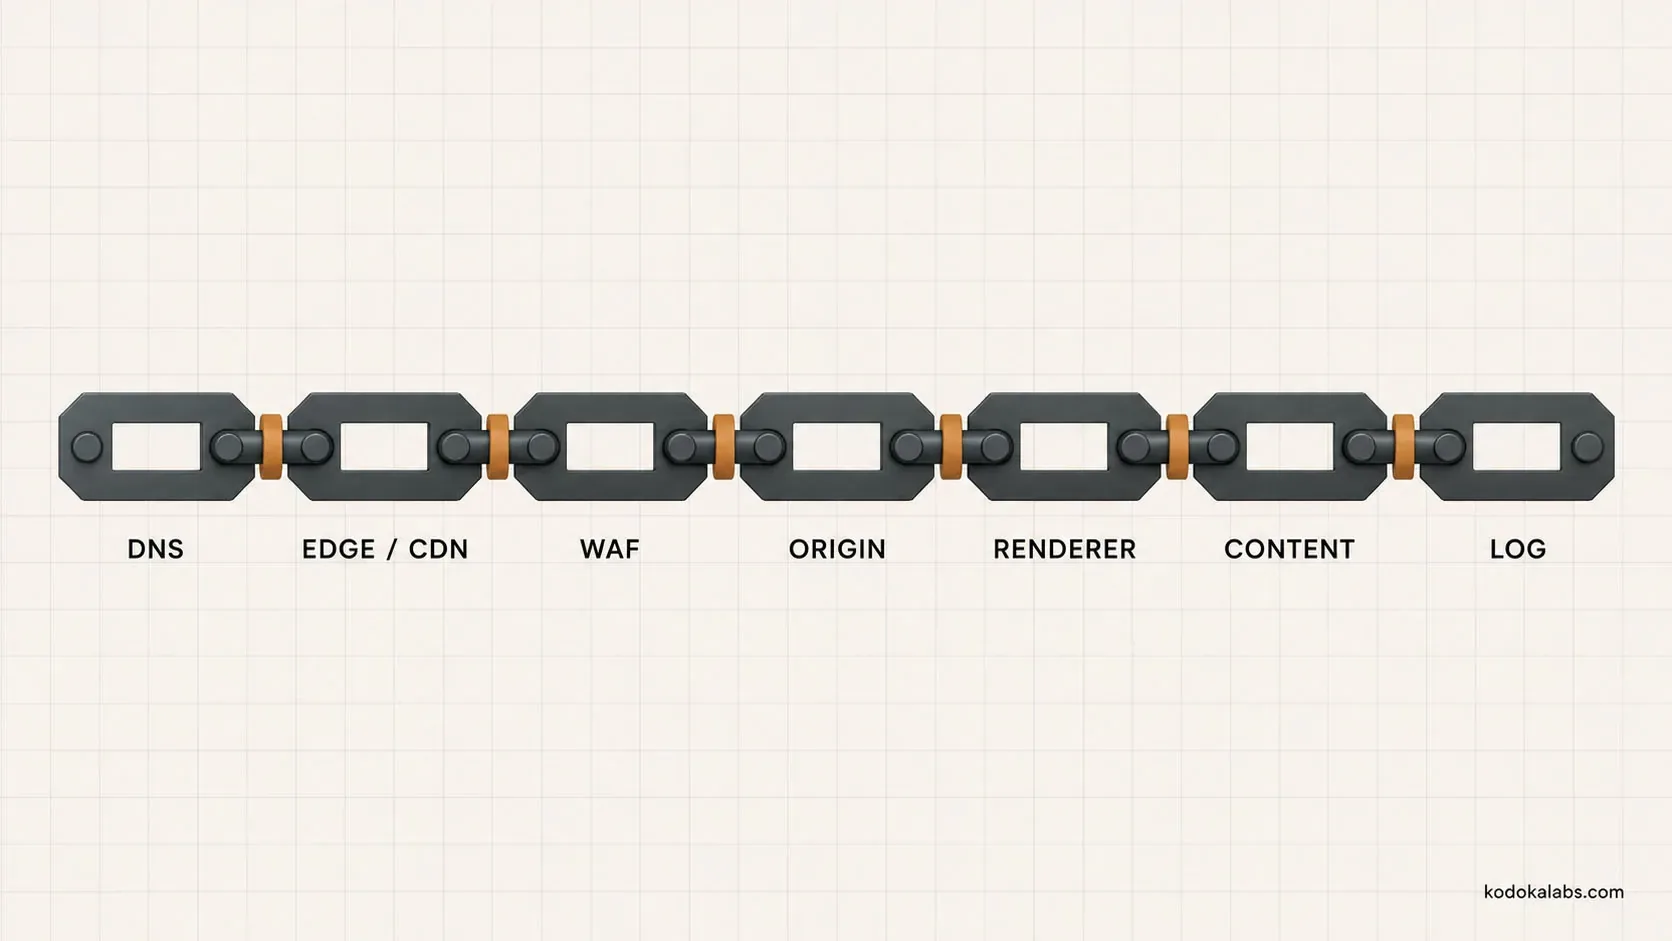
El GEO técnico es la disciplina de implementación que consiste en lograr que el contenido público que una organización quiere mostrar sea realmente accesible, descargable e interpretable para los crawlers de IA y los sistemas de recuperación, sin renunciar a los controles de seguridad, privacidad, propiedad intelectual y operativa que la organización ha decidido adoptar. La idea técnica central de esta guía: un archivo robots.txt bien configurado es necesario en algunos casos, pero por sí solo no basta. La entrega del contenido depende de una cadena de sistemas independientes (DNS, CDN, reglas del firewall de aplicaciones web (WAF), autenticación, renderizado en servidor o en cliente, etiquetas canonical, códigos de estado HTTP y sitemaps), y un fallo en cualquier eslabón puede bloquear en silencio el acceso de los crawlers de IA aunque la configuración de robots parezca correcta.
Esta guía está escrita para quienes implementan y gestionan estos controles: responsables de SEO técnico, propietarios de plataformas web, desarrolladores y responsables de seguridad o de CDN. Cualquier recomendación que implique reglas de WAF, listas de IP permitidas o cambios de acceso a nivel de infraestructura requiere la revisión y la aprobación de la persona responsable de seguridad de la organización antes de su implantación; esta guía aporta el framework técnico para esa conversación, pero no la sustituye.
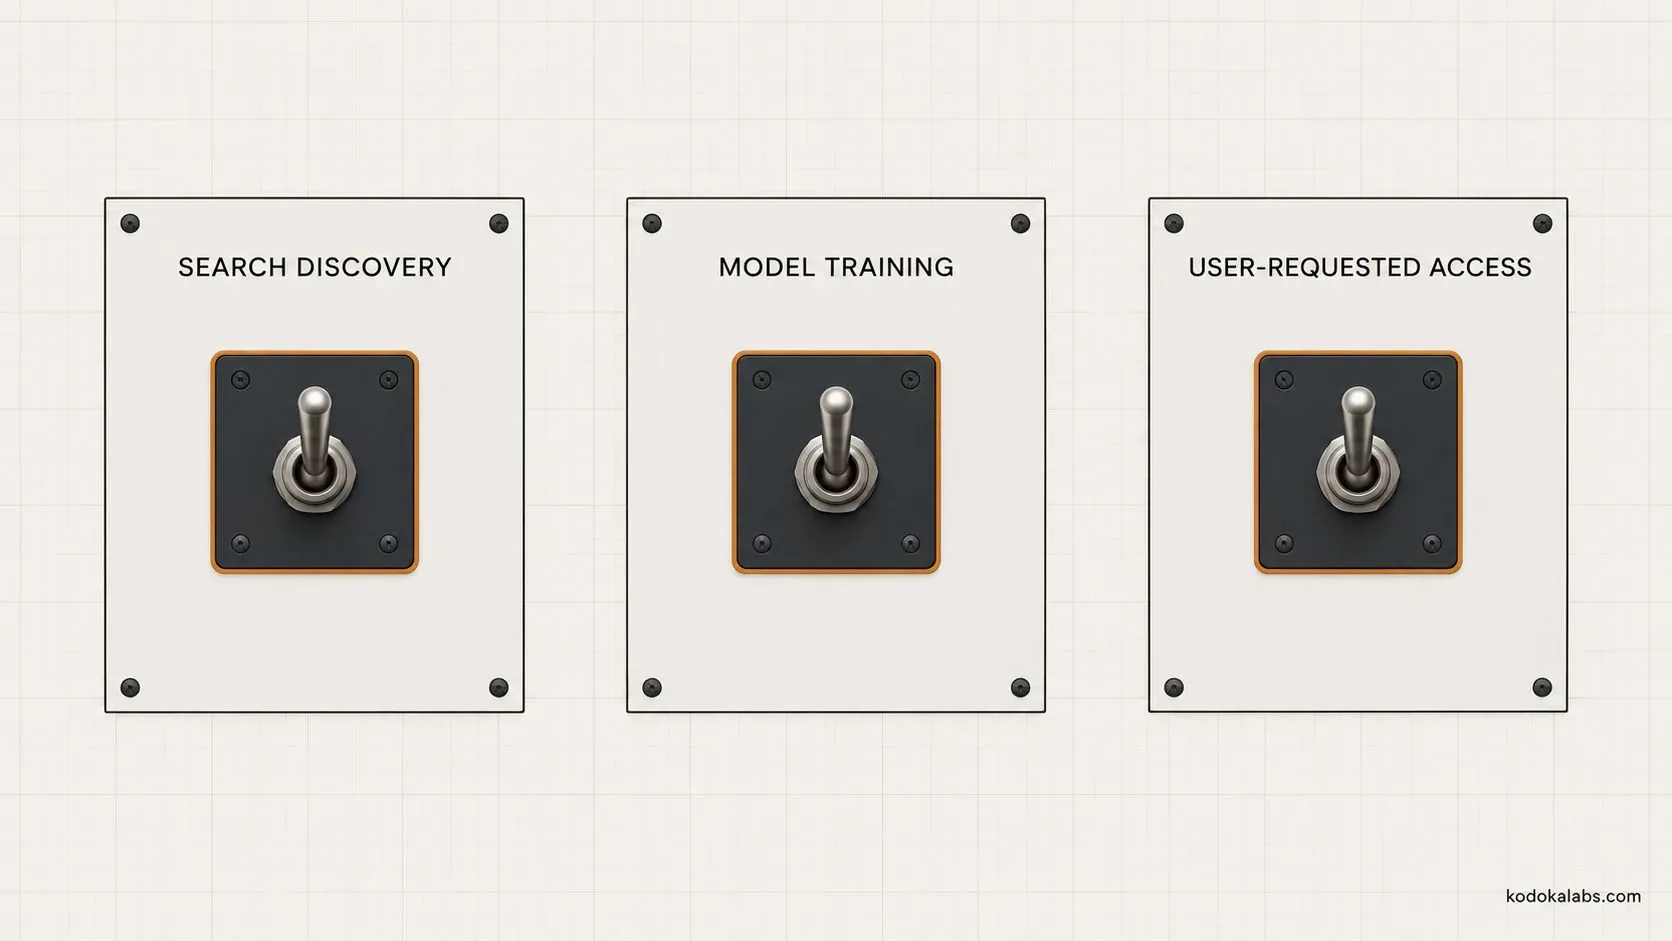
Una distinción fundamental que recorre toda la guía: el acceso para búsqueda y descubrimiento, la recuperación solicitada por el usuario y la recopilación de datos para entrenar modelos son finalidades distintas, a menudo gobernadas por tokens de crawler diferentes del mismo proveedor, y no deben tratarse como un único interruptor. Bloquear el crawler de datos de entrenamiento de un proveedor no bloquea necesariamente su crawler de búsqueda y descubrimiento, y a la inversa; cada uno requiere su propia decisión de política, tomada de forma deliberada.
Taxonomía de crawlers según su finalidad
Para entender el acceso de los crawlers de IA hay que partir de que una misma empresa de IA suele operar varios crawlers o tokens de user-agent, documentados por separado, para distintas finalidades, y que confundirlos es uno de los errores más habituales y de más consecuencias en el GEO técnico.
OpenAI documenta esta separación de forma explícita: OAI-SearchBot (se abre en una pestaña nueva) sirve para descubrir y recuperar contenido que ChatGPT puede buscar y, en su caso, citar en respuestas de tipo búsqueda, mientras que GPTBot se usa para el entrenamiento de modelos y puede controlarse con independencia del descubrimiento en búsqueda (preguntas frecuentes de OpenAI para editores y desarrolladores, consultadas el 14-09-2026). Existe además un token ChatGPT-User para las descargas en tiempo real que desencadena el usuario, por ejemplo cuando pide a ChatGPT que recupere o navegue una página concreta, distinto de los dos anteriores; conviene comprobar la documentación vigente sobre el comportamiento exacto de este token antes de basarse en él, ya que los propios materiales de OpenAI señalan que evoluciona con las funciones del producto.
Perplexity documenta una separación de finalidades comparable: un crawler de indexación que se usa para construir de antemano su índice de búsqueda y, por otro lado, un comportamiento de descarga en tiempo real que se activa cuando una consulta concreta exige una recuperación en directo, cada uno con su propia cadena de user-agent publicada y sus rangos de IP documentados para la verificación (documentación de crawlers de Perplexity, consultada el 14-09-2026).
La documentación de Google describe Google-Extended (se abre en una pestaña nueva) como un token de control, y no como un user agent solicitante independiente con su propio comportamiento de rastreo; permite a un sitio decidir si el contenido ya alcanzado por el rastreo normal de Googlebot puede utilizarse para el entrenamiento de IA de Google y para determinadas funciones generativas, y Google aclara que no controla la inclusión en la Búsqueda de Google (documentación de crawlers de Google, consultada el 14-09-2026). Googlebot y Bingbot siguen siendo los crawlers principales, documentados desde hace tiempo, del índice de búsqueda básico de cada motor, del que dependen en gran medida las funciones de IA descritas en otras partes de este pilar.
| Proveedor | Agente o token | Finalidad declarada | Distinto de |
|---|---|---|---|
| OpenAI | OAI-SearchBot |
Descubrimiento y recuperación de búsqueda para las respuestas de tipo búsqueda de ChatGPT | GPTBot (entrenamiento), ChatGPT-User (descarga desencadenada por el usuario) |
| OpenAI | GPTBot |
Recopilación de datos para el entrenamiento de modelos | OAI-SearchBot, ChatGPT-User |
| OpenAI | ChatGPT-User |
Descarga en tiempo real desencadenada por una petición concreta del usuario | OAI-SearchBot, GPTBot (compruebe la documentación vigente antes de basarse en el comportamiento exacto) |
| Perplexity | Crawler de indexación (consulte la documentación vigente de Perplexity para el nombre exacto del token) | Construcción del índice de búsqueda de Perplexity | El comportamiento independiente de descarga en tiempo real de Perplexity |
| Perplexity | Descarga en tiempo real por el usuario | Recuperación en directo desencadenada por una consulta concreta | El crawler de indexación de Perplexity |
Googlebot |
Rastreo e indexación de la Búsqueda básica | Google-Extended (un token de control, no un crawler independiente) |
|
Google-Extended |
Controla la elegibilidad de Gemini y de determinados usos de entrenamiento o grounding de funciones de IA sobre contenido ya rastreado | No controla la inclusión en la Búsqueda de Google | |
| Microsoft | Bingbot |
Rastreo e indexación de la Búsqueda básica de Bing, base del grounding web de Copilot | N/A |
Vuelva a verificar cada fila de esta tabla con la documentación vigente y en directo de los proveedores justo antes de la implantación; estos tokens y los comportamientos documentados ya han cambiado antes y pueden volver a cambiar sin previo aviso.
Robots y controles a nivel de página
El Protocolo de Exclusión de Robots, estandarizado en la RFC 9309 del IETF, es una convención de control de crawlers: indica a un crawler que se comporta bien qué se le pide que no descargue. No es, en absoluto, un mecanismo de autorización de acceso; depende por completo de que el crawler solicitante decida respetarlo y no ofrece ninguna barrera real de seguridad frente a un crawler, o a cualquier otro cliente automatizado, que decida no cumplirlo. Esta distinción afecta directamente a cómo debe pensar una organización su robots.txt: expresa una política dirigida a crawlers cooperativos e identificables, pero no hace cumplir un control de acceso.
A nivel de página, las directivas de robots.txt, las etiquetas meta robots y la cabecera HTTP X-Robots-Tag ofrecen cada una un nivel de granularidad distinto: robots.txt opera a nivel de ruta o de sitio, mientras que las etiquetas meta robots y X-Robots-Tag pueden aplicar un control por directiva (como noindex o nosnippet) a una página concreta o a una respuesta HTTP específica. Cuando una organización quiere que una página se rastree pero no se use en determinadas funciones de tipo snippet, nosnippet y directivas comparables, documentadas por plataforma, son la herramienta (en inglés) correcta, y no un bloqueo general de robots, que impediría el rastreo por completo.
Esta guía no publica, deliberadamente, una política de robots universal para copiar y pegar. La política correcta depende de la postura competitiva, la estrategia de contenidos y la tolerancia al riesgo de cada organización, decisiones que se tratan en la sección «Decisiones de política y reversión» y que deben tomarse de forma deliberada, en lugar de adoptar una plantilla genérica.
Acceso a nivel de infraestructura
Además de robots.txt, varias capas de infraestructura pueden bloquear o degradar por su cuenta el acceso de los crawlers de IA, sea cual sea la configuración de robots. Un CDN o un WAF puede aplicar reglas de gestión de bots que bloquean o desafían a clientes automatizados, incluidos crawlers legítimos y bien comportados, salvo que se incluyan de forma explícita en una lista de permitidos; con frecuencia es la verdadera causa de que una plataforma de IA no acceda al contenido aunque el propietario del sitio crea que las reglas de robots lo permiten. Los requisitos de autenticación o de capa de consentimiento colocados delante de contenido por lo demás público bloquearán a cualquier crawler que no pueda superarlos, incluidos los de IA.
Incluir a un crawler en la lista de permitidos del WAF o del CDN nunca debe apoyarse solo en la confianza en la cadena User-Agent, ya que cualquier cliente puede falsificarla con facilidad. Verifique la identidad del crawler con el método de verificación que publica el propio proveedor, normalmente una búsqueda DNS inversa que confirme que la IP solicitante se resuelve en el dominio documentado del proveedor, contrastada con los rangos de IP publicados cuando existan. Cualquier cambio en las reglas de listas de permitidos del WAF o del CDN es una decisión de infraestructura y de seguridad que requiere la revisión y la aprobación de la persona responsable de seguridad de la organización antes de la implantación, con monitorización posterior y una vía de reversión documentada por si el cambio tiene efectos no deseados.
Renderizado y entrega del contenido
Que el contenido se sirva mediante renderizado en servidor, generación estática o renderizado con JavaScript en el cliente influye directamente en la accesibilidad para los crawlers de IA, ya que no todos ejecutan JavaScript de forma fiable, o directamente no lo ejecutan. El contenido que depende por completo del renderizado en cliente para hacerse visible corre más riesgo de que un crawler que no ejecute los scripts correspondientes lo descargue como una página prácticamente vacía o incompleta. La entrega del contenido esencial renderizada en servidor o prerrenderizada, con JavaScript que lo enriquece en lugar de producir por sí solo el texto fundamental, es el patrón más accesible de forma fiable para una gama más amplia de crawlers.
Las etiquetas canonical deben resolverse de forma correcta y coherente, ya que un crawler que se encuentre con señales canonical contradictorias o rotas puede tratar como oficial la versión equivocada de una página, o descartar por completo sus señales. Los sitemaps deben reflejar con exactitud el conjunto actual y previsto de URL públicas, porque un sitemap desactualizado puede dejar fuera contenido nuevo o seguir refiriéndose a contenido retirado, y ambas cosas generan ruido para cualquier crawler que dependa de él.
Auditoría y prueba de aceptación
Antes de afirmar que una página o un sitio es accesible para un crawler de IA concreto, compruébelo de forma directa en lugar de darlo por supuesto a partir de la intención de la configuración. kōdōkalabs utiliza una prueba de aceptación de GEO técnico (Technical GEO Acceptance Test) que cubre toda la cadena de entrega.
| Comprobación | Qué verificar |
|---|---|
| DNS | El dominio se resuelve de forma correcta y coherente para la ruta de la petición del crawler |
| TLS | Se presenta un certificado TLS válido y vigente; el crawler puede completar el handshake |
| Estado HTTP | La página devuelve un auténtico 200 OK a la petición del crawler, y no un error encubierto, una redirección inesperada o una página de bloqueo |
| Robots | Se revisan robots.txt, meta robots y las directivas X-Robots-Tag, y se confirma que permiten el acceso previsto |
| Firewall o WAF | El crawler específico, con la IP verificada, no es bloqueado ni desafiado por las reglas de gestión de bots |
| Renderizado | El contenido que recibe realmente un crawler, probado con una descarga equivalente a la de un crawler, coincide con la página completamente renderizada que ve una persona |
| Texto visible | Los datos y definiciones clave que la organización quiere que se puedan recuperar están presentes en el contenido descargado, y no solo en una imagen o en un script sin renderizar |
| Enlaces | Los enlaces internos relevantes para la navegación y el contexto temático se resuelven correctamente en el contenido descargado |
| Canonicals | Las etiquetas canonical se resuelven en la URL oficial correcta y prevista |
| Cabeceras | Las cabeceras de respuesta HTTP relevantes (incluidas X-Robots-Tag y las de caché) reflejan la política prevista |
| Schema | Los datos estructurados del contenido descargado están presentes, son válidos y se ajustan al estándar compartido de metadatos y schema de este pilar |
| Rendimiento | El tiempo de carga y de respuesta de la página se mantiene en un rango razonable que no arriesga fallos por timeout en las descargas automatizadas |
| Logs | Los logs del servidor muestran peticiones correctas y verificadas del crawler previsto, y no solo de cadenas User-Agent falsificadas o no verificadas |
Ejecutar esta prueba completa sobre una muestra de páginas prioritarias, para cada crawler de IA que la organización haya decidido permitir, es la única forma fiable de confirmar la accesibilidad real; la revisión de la configuración por sí sola puede pasar por alto fallos reales que introduce cualquier eslabón de la cadena.
 Generada con IA imagen
Diagrama de la ruta de la petición
 Generada con IA imagen
Decisiones de política y reversión
Decidir qué crawlers se permiten y con qué finalidad es una decisión de negocio y de seguridad, no un ajuste técnico por defecto. Elabore una matriz de control de acceso de IA (AI Access Control Matrix) que recoja, para cada proveedor y token: la finalidad declarada, el comportamiento actual de robots y de infraestructura, la fuente de verificación de IP utilizada para confirmar la identidad, la política deseada por la organización, una persona responsable, la prueba de validación con la que se confirma que la política está realmente en vigor, la fecha de la última comprobación y un nivel de riesgo declarado por equivocarse en la decisión en cualquiera de los dos sentidos.
| Campo | Finalidad |
|---|---|
| Proveedor y agente/token | Identifica con exactitud qué crawler o token rige esta fila |
| Finalidad declarada | Para qué dice el proveedor que se usa este crawler, según la documentación vigente |
| Comportamiento de robots | Tratamiento actual de este agente en robots.txt, meta y cabeceras |
| Fuente de verificación de IP | El método publicado por el proveedor para confirmar que las peticiones proceden realmente de este crawler |
| Política deseada | Permitir, bloquear o permitir con condiciones, y bajo qué condiciones |
| Responsable | Quién responde de esta decisión de política y de su implantación |
| Prueba de validación | Cómo se confirma el efecto real de la política, con referencia a la prueba de aceptación anterior |
| Última comprobación | La fecha en que se verificó por última vez esta fila con la documentación y el comportamiento reales |
| Riesgo | El riesgo que la organización atribuye a la política actual, valorado con honestidad en ambos sentidos |
Cualquier cambio en esta matriz que afecte a reglas de WAF o de infraestructura debe seguir un proceso de despliegue deliberado: documentar el cambio previsto y su justificación, obtener la aprobación de la persona responsable de seguridad, implantarlo con monitorización y mantener una vía de reversión clara por si el cambio produce efectos no deseados, como bloquear a un crawler legítimo o, al contrario, permitir más acceso del previsto.
Modos de fallo
El modo de fallo más habitual es suponer que la configuración de robots.txt determina por sí sola la accesibilidad, cuando la causa real, sin examinar, de un fallo de acceso es una regla de WAF, un requisito de autenticación o un patrón de renderizado solo en cliente. Un segundo modo de fallo frecuente es fiarse de la cadena User-Agent para las decisiones de listas de permitidos, que es muy fácil de falsificar y no ofrece una verificación real. Un tercero es tratar a todos los crawlers de IA de un mismo proveedor como un único interruptor: bloquear un crawler de entrenamiento con la creencia equivocada de que con ello también se bloquea el acceso de búsqueda y descubrimiento, o al revés.
Preguntas frecuentes
¿Bloquear GPTBot bloquea también OAI-SearchBot?
No. OpenAI los documenta como tokens separados para finalidades distintas: la recopilación de datos de entrenamiento y el descubrimiento en búsqueda. Según la documentación actual, bloquear uno no bloquea el otro; cada uno requiere su propia decisión de política, tomada de forma deliberada.
¿Es robots.txt un control de seguridad?
robots.txt un control de seguridad?No. Es una convención que se espera que respeten los crawlers cooperativos y bien comportados; no ofrece ninguna garantía frente a un cliente que la ignore. Un control de acceso real exige medidas a nivel de infraestructura, como reglas de WAF verificadas mediante autenticación basada en IP, y no solo directivas de robots.
¿Controla Google-Extended si aparece en los resultados de la Búsqueda de Google?
Google-Extended si aparece en los resultados de la Búsqueda de Google?No, según la propia documentación de Google. Es un token de control que regula la elegibilidad para determinados usos de entrenamiento y de grounding de funciones de IA sobre contenido ya rastreado; no controla la inclusión en la Búsqueda de Google.
¿Cómo se verifica que un crawler es realmente quien dice ser?
Con el método de verificación que publica el propio proveedor, normalmente una consulta DNS inversa que confirme que la IP solicitante se resuelve en el dominio documentado del proveedor, contrastada con los rangos de IP publicados cuando existan. No se debe confiar nunca solo en la cadena User-Agent.
¿Quién debería ser responsable de esta política dentro de su organización?
Una combinación del SEO técnico o la estrategia de búsqueda (que fija la política deseada) y la responsabilidad de seguridad o de infraestructura (que la implanta y la monitoriza); esta guía parte de que intervienen ambas, y no una de ellas por su cuenta.
¿Por dónde empezar?
Por la matriz de control de acceso de IA, rellenada con su configuración real y actual de robots e infraestructura y verificada con la prueba de aceptación, no supuesta a partir de la intención de la configuración.
Vías de solución en contexto
Audite si su infraestructura y su política permiten la visibilidad que espera su estrategia, dentro de un proyecto completo de AI Marketing Operating System, con responsabilidades claras y la gobernanza integrada desde el principio.