Definition, Risiko und Kontrollen
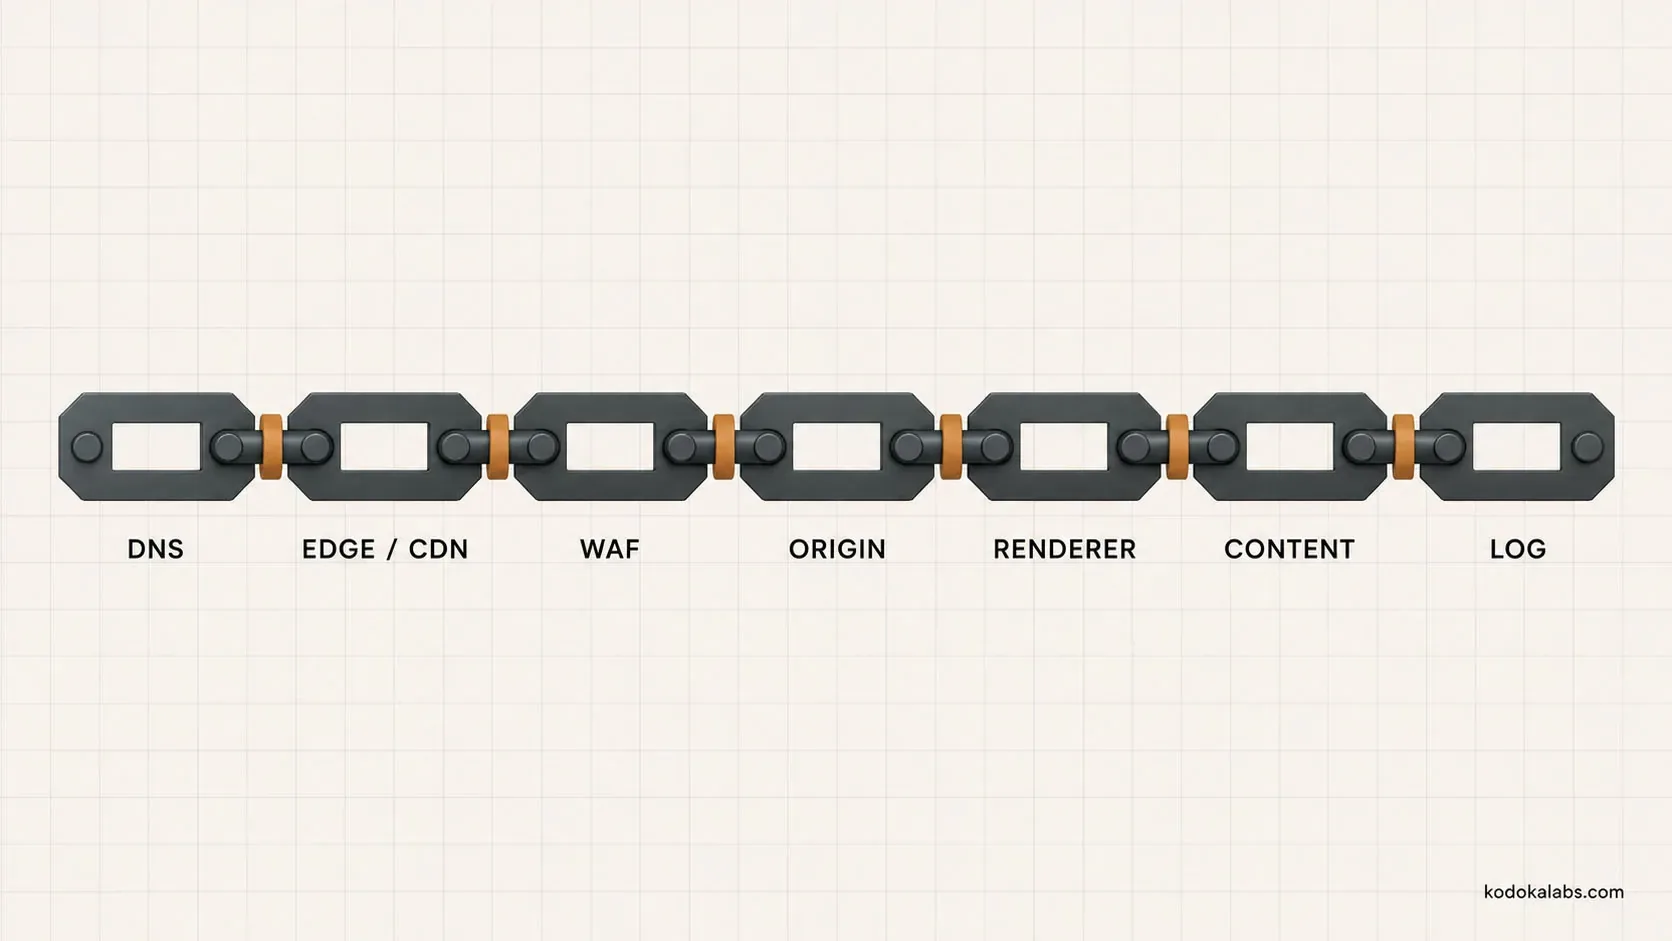
Technical GEO ist die Umsetzungsdisziplin, die dafür sorgt, dass die öffentlich vorgesehenen Inhalte eines Unternehmens für KI-Crawler und Retrieval-Systeme tatsächlich erreichbar, abrufbar und interpretierbar sind, und zwar unter Wahrung der Sicherheits-, Datenschutz-, Urheberrechts- und Betriebskontrollen, für die sich das Unternehmen bewusst entschieden hat. Die technische Kernaussage dieses Leitfadens: Eine korrekt konfigurierte robots.txt ist in manchen Fällen notwendig, aber für sich allein nicht ausreichend. Die Auslieferung von Inhalten hängt von einer Kette unabhängiger Systeme ab: DNS, CDN, Regeln der Web Application Firewall (WAF), Authentifizierung, serverseitiges oder clientseitiges Rendering, Canonical-Tags, HTTP-Statuscodes und Sitemaps. Ein Fehler an irgendeiner Stelle dieser Kette kann den Zugriff von KI-Crawlern unbemerkt blockieren, selbst wenn die robots-Konfiguration korrekt aussieht.
Dieser Leitfaden richtet sich an die Menschen, die diese Kontrollen tatsächlich umsetzen und verantworten: Leitungen im technischen SEO, Verantwortliche für die Web-Plattform, Entwicklungsteams sowie die Verantwortlichen für Sicherheit oder CDN. Jede Empfehlung zu WAF-Regeln, IP-Allowlisting oder Zugriffsänderungen auf Infrastrukturebene braucht vor der Umsetzung die Prüfung und Freigabe durch die Sicherheitsverantwortlichen des Unternehmens. Dieser Leitfaden liefert das technische Framework für dieses Gespräch, er ersetzt es nicht.
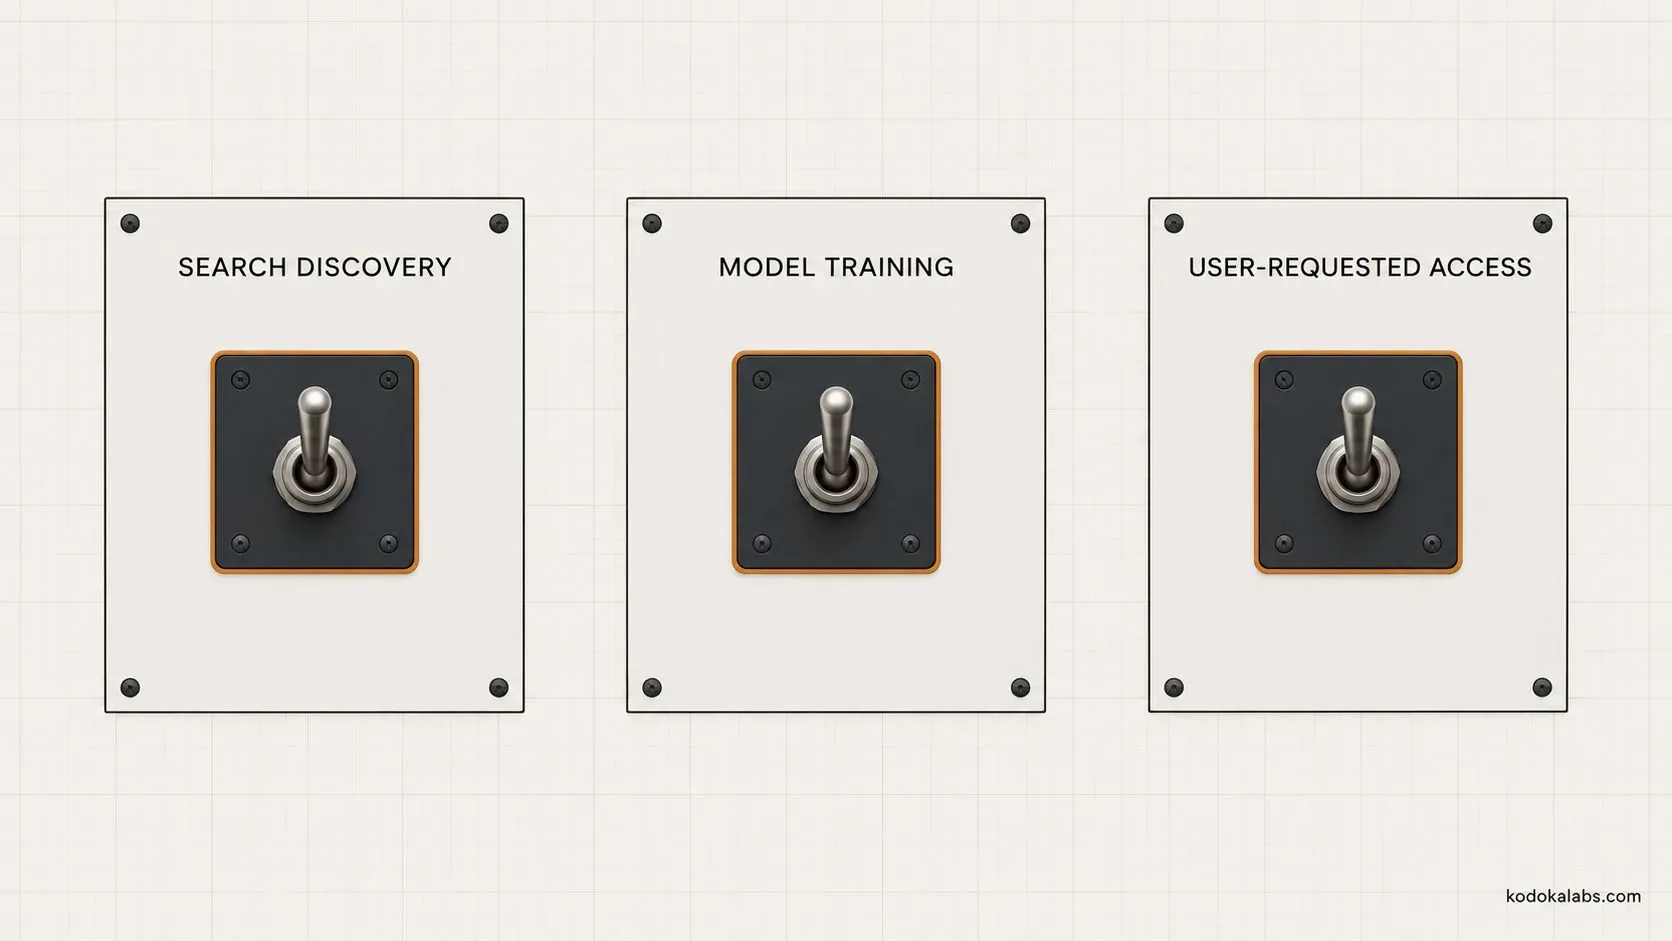
Eine grundlegende Unterscheidung zieht sich durch den gesamten Leitfaden: Such- und Auffindbarkeitszugriff, nutzerinitiierter Abruf und das Sammeln von Trainingsdaten für Modelle sind getrennte Zwecke, die häufig über getrennte Crawler-Token desselben Anbieters gesteuert werden und nicht als ein einziger Schalter behandelt werden dürfen. Wer den Trainingsdaten-Crawler eines Anbieters sperrt, sperrt damit nicht zwingend dessen Crawler für die Suche, und umgekehrt gilt dasselbe. Jeder Zweck braucht eine eigene, bewusste Entscheidung.
Taxonomie der Crawler-Zwecke
Zugriff für KI-Crawler zu verstehen heißt zunächst zu verstehen, dass ein einzelnes KI-Unternehmen häufig mehrere, getrennt dokumentierte Crawler oder User-Agent-Token für unterschiedliche Zwecke betreibt. Diese zu verwechseln, gehört zu den häufigsten und folgenreichsten Fehlern im Technical GEO.
OpenAI dokumentiert diese Trennung ausdrücklich: OAI-SearchBot (öffnet in einem neuen Tab) dient dazu, Inhalte zu finden und abzurufen, die ChatGPT in suchähnlichen Antworten durchsuchen und womöglich zitieren kann, während GPTBot für das Modelltraining genutzt wird und unabhängig von der Suche gesteuert werden kann (OpenAI-FAQ für Publisher und Entwickler, Stand: 14. September 2026). Daneben gibt es ein eigenes Token ChatGPT-User für Abrufe in Echtzeit, die ein Nutzer auslöst, etwa wenn er ChatGPT bittet, eine bestimmte Seite direkt abzurufen oder zu durchsuchen. Es ist von beiden zuvor genannten getrennt. Prüfen Sie die aktuelle Dokumentation zum genauen Verhalten dieses Tokens, bevor Sie sich darauf stützen, denn OpenAI weist in den eigenen Unterlagen darauf hin, dass es sich mit den Produktfunktionen ändert.
Perplexity dokumentiert eine vergleichbare Zweckrennung: einen Indexierungs-Crawler, der den Suchindex im Voraus aufbaut, und ein davon getrenntes Echtzeit-Abrufverhalten für den Fall, dass eine konkrete Anfrage Live-Retrieval erfordert. Beide haben einen eigenen veröffentlichten User-Agent-String und dokumentierte IP-Bereiche zur Verifizierung (Perplexity-Crawler-Dokumentation, Stand: 14. September 2026).
Googles Dokumentation beschreibt Google-Extended (öffnet in einem neuen Tab) als Steuerungs-Token und nicht als eigenen anfragenden User-Agent mit eigenem Crawl-Verhalten. Es erlaubt einer Website festzulegen, ob Inhalte, die der normale Googlebot-Crawl bereits erreicht hat, für das KI-Training von Google und bestimmte generative Funktionen infrage kommen. Google betont ausdrücklich, dass es nicht steuert, ob eine Seite in die Google-Suche aufgenommen wird (Google-Crawler-Dokumentation, Stand: 14. September 2026). Googlebot und Bingbot bleiben die seit Langem dokumentierten Haupt-Crawler für den Kernindex der jeweiligen Suchmaschine, von dem die an anderer Stelle in diesem Themenfeld beschriebenen KI-Funktionen wesentlich abhängen.
| Anbieter | Agent oder Token | Angegebener Zweck | Abzugrenzen von |
|---|---|---|---|
| OpenAI | OAI-SearchBot |
Auffinden und Abrufen von Inhalten für suchähnliche ChatGPT-Antworten | GPTBot (Training), ChatGPT-User (nutzerausgelöster Abruf) |
| OpenAI | GPTBot |
Sammeln von Trainingsdaten für Modelle | OAI-SearchBot, ChatGPT-User |
| OpenAI | ChatGPT-User |
Echtzeit-Abruf, ausgelöst durch eine konkrete Nutzeranfrage | OAI-SearchBot, GPTBot (genaues Verhalten vor der Nutzung in der aktuellen Dokumentation prüfen) |
| Perplexity | Indexierungs-Crawler (genauen Token-Namen in der aktuellen Perplexity-Dokumentation nachlesen) | Aufbau des Suchindex von Perplexity | Echtzeit-Abrufverhalten von Perplexity für Nutzeranfragen |
| Perplexity | Echtzeit-Abruf für Nutzeranfragen | Live-Abruf, ausgelöst durch eine konkrete Anfrage | Indexierungs-Crawler von Perplexity |
Googlebot |
Crawling und Indexierung für die Kernsuche | Google-Extended (ein Steuerungs-Token, kein eigener Crawler) |
|
Google-Extended |
Steuert, ob bereits gecrawlte Inhalte für Gemini und bestimmte KI-Funktionen (Training und Grounding) infrage kommen | Steuert nicht die Aufnahme in die Google-Suche | |
| Microsoft | Bingbot |
Crawling und Indexierung für die Bing-Kernsuche, Grundlage des Web-Groundings von Copilot | Entfällt |
Prüfen Sie jede Zeile dieser Tabelle unmittelbar vor der Umsetzung noch einmal gegen die aktuelle, öffentliche Dokumentation der Anbieter. Diese Token und ihr dokumentiertes Verhalten haben sich schon verändert und können sich ohne Vorankündigung erneut ändern.
Robots und Steuerung auf Seitenebene
Das Robots Exclusion Protocol, standardisiert in IETF RFC 9309, ist eine Konvention zur Crawler-Steuerung: Es teilt einem wohlerzogenen Crawler mit, was er nicht abrufen soll. Es ist ausdrücklich kein Mechanismus zur Zugriffsberechtigung. Es beruht vollständig darauf, dass sich der anfragende Crawler daran hält, und bietet keinerlei echte Sicherheitsschranke gegen einen Crawler oder einen anderen automatisierten Client, der sich nicht daran halten will. Diese Unterscheidung bestimmt direkt, wie ein Unternehmen über die robots.txt denken sollte: Sie formuliert eine Richtlinie gegenüber kooperativen, identifizierbaren Crawlern, sie setzt keine Zugriffskontrolle durch.
Auf Seitenebene bieten robots.txt-Direktiven, Meta-Robots-Tags und der HTTP-Header X-Robots-Tag jeweils eine andere Granularität: Die robots.txt wirkt auf Pfad- oder Website-Ebene, während Meta-Robots-Tags und X-Robots-Tag Direktiven wie noindex oder nosnippet für eine einzelne Seite oder eine bestimmte HTTP-Antwort festlegen können. Soll eine Seite gecrawlt, aber nicht in snippetartigen Funktionen verwendet werden, sind nosnippet und vergleichbare, je Plattform dokumentierte Direktiven das richtige Werkzeug (auf Englisch), keine pauschale robots-Sperre, die das Crawling komplett verhindern würde.
Dieser Leitfaden veröffentlicht bewusst keine universelle Robots-Richtlinie zum Kopieren. Die richtige Richtlinie hängt von der Wettbewerbshaltung, der Content-Strategie und der Risikobereitschaft des jeweiligen Unternehmens ab. Diese Entscheidungen behandelt der Abschnitt „Richtlinienentscheidungen und Rollback“ weiter unten, und sie müssen bewusst getroffen und nicht als generische Vorlage übernommen werden.
Zugriff auf Infrastrukturebene
Neben der robots.txt können mehrere Infrastrukturschichten den Zugriff von KI-Crawlern unabhängig von der robots-Konfiguration blockieren oder beeinträchtigen. Ein CDN oder eine WAF kann Bot-Management-Regeln anwenden, die automatisierte Clients blockieren oder herausfordern, auch legitime, wohlerzogene Crawler, sofern diese nicht ausdrücklich auf die Allowlist gesetzt wurden. Das ist häufig die tatsächliche Ursache, wenn eine KI-Plattform nicht auf Inhalte zugreifen kann, obwohl die Website-Betreiber glauben, die robots-Regeln erlaubten es. Authentifizierungs- oder Consent-Schichten vor ansonsten öffentlichen Inhalten sperren jeden Crawler aus, der sie nicht passieren kann, KI-Crawler eingeschlossen.
Das Allowlisting eines Crawlers auf WAF- oder CDN-Ebene darf sich nie allein auf den User-Agent-String stützen, denn dieser lässt sich von jedem Client mühelos fälschen. Verifizieren Sie die Identität des Crawlers über das vom Anbieter veröffentlichte Verfahren, in der Regel über einen Reverse-DNS-Lookup, der bestätigt, dass die anfragende IP-Adresse zur dokumentierten Domain des Anbieters gehört, und gleichen Sie sie, wo verfügbar, mit den veröffentlichten IP-Bereichen des Anbieters ab. Jede Änderung an WAF- oder CDN-Allowlist-Regeln ist eine Infrastruktur- und Sicherheitsentscheidung. Sie erfordert vor der Umsetzung die Prüfung und Freigabe durch die Sicherheitsverantwortlichen, danach ein Monitoring und einen dokumentierten Rollback-Pfad für den Fall unbeabsichtigter Folgen.
Rendering und Auslieferung von Inhalten
Ob Inhalte per serverseitigem Rendering, statischer Generierung oder clientseitigem JavaScript-Rendering ausgeliefert werden, wirkt sich unmittelbar auf die Zugänglichkeit für KI-Crawler aus, denn nicht jeder Crawler führt JavaScript zuverlässig oder überhaupt aus. Inhalte, die nur durch clientseitiges Rendering sichtbar werden, laufen eher Gefahr, von einem Crawler, der die betreffenden Skripte nicht ausführt, als faktisch leere oder unvollständige Seite abgerufen zu werden. Die zuverlässigere Variante für ein breites Spektrum von Crawlern ist die server- oder vorgerenderte Auslieferung der Kerninhalte, bei der JavaScript den wesentlichen Text ergänzt und nicht allein erzeugt.
Canonical-Tags müssen korrekt und konsistent aufgelöst werden. Ein Crawler, der widersprüchliche oder defekte Canonical-Signale vorfindet, kann die falsche Version einer Seite als maßgeblich ansehen oder die Signale der Seite insgesamt abwerten. Sitemaps sollten die aktuelle, beabsichtigte Menge öffentlicher URLs korrekt abbilden, denn eine veraltete Sitemap kann neue Inhalte übersehen oder weiter auf entfernte verweisen. Beides erzeugt Rauschen für jeden Crawler, der sich darauf verlässt.
Audit und Abnahmetest
Bevor Sie behaupten, eine Seite oder Website sei für einen bestimmten KI-Crawler zugänglich, prüfen Sie es direkt, statt von der Konfigurationsabsicht auszugehen. kōdōkalabs nutzt dafür einen Technical GEO Acceptance Test, der die gesamte Auslieferungskette abdeckt.
| Prüfpunkt | Was zu verifizieren ist |
|---|---|
| DNS | Die Domain wird für den Anfragepfad des Crawlers korrekt und konsistent aufgelöst |
| TLS | Ein gültiges, aktuelles TLS-Zertifikat wird ausgeliefert, und der Crawler kann den Handshake abschließen |
| HTTP-Status | Die Seite liefert auf die Anfrage des Crawlers ein echtes 200 OK, keinen Soft-Error, keine unerwartete Weiterleitung und keine Blockadeseite |
| Robots | robots.txt, Meta-Robots und X-Robots-Tag-Direktiven sind geprüft und erlauben nachweislich den beabsichtigten Zugriff |
| Firewall oder WAF | Der konkrete, per IP verifizierte Crawler wird von den Bot-Management-Regeln weder blockiert noch herausgefordert |
| Rendering | Der Inhalt, den ein Crawler tatsächlich erhält, entspricht in einem crawlerähnlichen Abruf der vollständig gerenderten Seite, die ein Mensch sieht |
| Sichtbarer Text | Die Kernfakten und Definitionen, die auffindbar sein sollen, stehen im abgerufenen Inhalt und nicht nur in einem Bild oder einem nicht gerenderten Skript |
| Links | Interne Links, die für Navigation und thematischen Kontext relevant sind, werden im abgerufenen Inhalt korrekt aufgelöst |
| Canonicals | Canonical-Tags verweisen auf die richtige, maßgebliche URL |
| Header | Relevante HTTP-Antwort-Header (darunter X-Robots-Tag und Caching-Header) spiegeln die beabsichtigte Richtlinie wider |
| Schema | Strukturierte Daten sind im abgerufenen Inhalt vorhanden, valide und entsprechen dem gemeinsamen Metadaten- und Schema-Standard dieses Themenfelds |
| Performance | Ladezeit und Antwortzeit liegen in einem Bereich, der keine Timeout-bedingten Fehler bei automatisierten Abrufen riskiert |
| Logs | Die Server-Logs zeigen erfolgreiche, verifizierte Anfragen des vorgesehenen Crawlers und nicht nur solche mit gefälschten oder unverifizierten User-Agent-Strings |
Diesen vollständigen Test an einer Stichprobe priorisierter Seiten für jeden KI-Crawler durchzuführen, den das Unternehmen zulassen will, ist die einzige verlässliche Möglichkeit, die tatsächliche Zugänglichkeit zu bestätigen. Eine reine Konfigurationsprüfung kann reale Fehler übersehen, die eine einzelne Schicht der Kette verursacht.
 KI-generiert Bild
 KI-generiert Bild
Richtlinienentscheidungen und Rollback
Welche Crawler zu welchem Zweck zugelassen werden, ist eine geschäftliche und sicherheitsrelevante Entscheidung und keine technische Standardeinstellung. Bauen Sie eine AI Access Control Matrix auf, die für jeden Anbieter und jedes Token festhält: den angegebenen Zweck, das aktuelle Verhalten bei robots und Infrastruktur, die Quelle der IP-Verifizierung zur Identitätsprüfung, die gewünschte Richtlinie des Unternehmens, eine verantwortliche Person, den Validierungstest, mit dem sich bestätigen lässt, dass die Richtlinie tatsächlich wirkt, das Datum der letzten Prüfung und eine Risikostufe für den Fall, dass die Entscheidung in die eine oder andere Richtung falsch ausfällt.
| Feld | Zweck |
|---|---|
| Anbieter und Agent/Token | Benennt genau, welchen Crawler oder welches Token diese Zeile regelt |
| Angegebener Zweck | Wofür der Anbieter diesen Crawler laut aktueller Dokumentation einsetzt |
| Robots-Verhalten | Aktuelle Behandlung dieses Agents in robots.txt, Meta-Tags und Headern |
| Quelle der IP-Verifizierung | Das vom Anbieter veröffentlichte Verfahren, mit dem sich bestätigen lässt, dass Anfragen tatsächlich von diesem Crawler stammen |
| Gewünschte Richtlinie | Zulassen, blockieren oder bedingt zulassen, und unter welchen Bedingungen |
| Verantwortliche Person | Wer für diese Richtlinienentscheidung und ihre Umsetzung verantwortlich ist |
| Validierungstest | Wie die tatsächliche Wirkung der Richtlinie bestätigt wird, mit Bezug auf den oben beschriebenen Abnahmetest |
| Zuletzt geprüft | Das Datum, an dem diese Zeile zuletzt gegen die aktuelle Dokumentation und das tatsächliche Verhalten geprüft wurde |
| Risiko | Das vom Unternehmen eingeschätzte Risiko der aktuellen Richtlinie, ehrlich in beide Richtungen betrachtet |
Jede Änderung an dieser Matrix, die WAF- oder Infrastrukturregeln berührt, sollte einem bewussten Rollout-Prozess folgen: die geplante Änderung und ihre Begründung dokumentieren, die Freigabe der Sicherheitsverantwortlichen einholen, mit Monitoring umsetzen und einen klaren Rollback-Pfad vorhalten, falls die Änderung unbeabsichtigte Folgen hat, etwa einen legitimen Crawler blockiert oder umgekehrt mehr Zugriff gewährt als gewollt.
Typische Fehlerbilder
Das häufigste Fehlerbild ist die Annahme, die robots.txt-Konfiguration allein bestimme die Zugänglichkeit, während in Wirklichkeit eine WAF-Regel, eine Authentifizierungsanforderung oder ein rein clientseitiges Rendering die eigentliche, nie untersuchte Ursache des Zugriffsfehlers ist. Ein zweites häufiges Fehlerbild ist das Vertrauen auf den User-Agent-String bei Allowlisting-Entscheidungen, der sich mühelos fälschen lässt und keine echte Verifizierung bietet. Ein drittes ist, alle KI-Crawler eines Anbieters wie einen einzigen Schalter zu behandeln: einen Trainings-Crawler zu sperren in der irrigen Annahme, damit sei auch der Zugriff für die Suche blockiert, oder umgekehrt.
Häufige Fragen
Blockiert die Sperrung von GPTBot auch OAI-SearchBot?
Nein. OpenAI dokumentiert diese als getrennte Token für getrennte Zwecke, das Sammeln von Trainingsdaten und die Suche. Die Sperrung des einen blockiert nach aktueller Dokumentation nicht das andere, und jedes braucht eine eigene, bewusste Richtlinienentscheidung.
Ist robots.txt eine Sicherheitskontrolle?
robots.txt eine Sicherheitskontrolle?Nein. Sie ist eine Konvention, an die sich wohlerzogene, kooperative Crawler halten sollen, und bietet keinerlei Durchsetzung gegenüber einem Client, der sie ignoriert. Echte Zugriffskontrolle erfordert Maßnahmen auf Infrastrukturebene wie WAF-Regeln, verifiziert über IP-basierte Authentifizierung, und nicht allein robots-Direktiven.
Steuert Google-Extended, ob Sie in den Google-Suchergebnissen erscheinen?
Google-Extended, ob Sie in den Google-Suchergebnissen erscheinen?Nein, laut Googles eigener Dokumentation nicht. Es ist ein Steuerungs-Token für die Eignung bereits gecrawlter Inhalte für bestimmte KI-Funktionen (Training und Grounding), und es steuert nicht die Aufnahme in die Google-Suche selbst.
Wie verifizieren Sie, dass ein Crawler wirklich der ist, für den er sich ausgibt?
Nutzen Sie das vom Anbieter veröffentlichte Verfahren, in der Regel einen Reverse-DNS-Lookup, der bestätigt, dass die anfragende IP-Adresse zur dokumentierten Domain des Anbieters gehört, und gleichen Sie sie, wo verfügbar, mit den veröffentlichten IP-Bereichen ab. Verlassen Sie sich nie allein auf den User-Agent-String.
Wer sollte diese Richtlinie im Unternehmen verantworten?
Eine Kombination aus technischem SEO oder Suchstrategie (legt die gewünschte Richtlinie fest) und Sicherheits- oder Infrastrukturverantwortung (setzt sie um und überwacht sie). Dieser Leitfaden geht davon aus, dass beide beteiligt sind und nicht eine Seite allein handelt.
Wo sollten Sie anfangen?
Mit der AI Access Control Matrix, befüllt mit Ihrer aktuellen, tatsächlichen robots- und Infrastrukturkonfiguration, geprüft anhand des Abnahmetests und nicht aus der Konfigurationsabsicht abgeleitet.
Passende Lösungswege
Prüfen Sie, ob Ihre Infrastruktur und Ihre Richtlinie die Sichtbarkeit ermöglichen, die Ihre Strategie erwartet: im Rahmen eines vollständigen AI Marketing Operating System mit klaren Verantwortlichkeiten und eingebauter Governance.