Das Wichtigste zum AI Editorial Operating System
- KI beschleunigt den Entwurf. Recherche, Urteilsvermögen, Prüfung und Verantwortung macht sie nicht überflüssig, und ein redaktionelles Betriebssystem, das die Entwurfsgeschwindigkeit für das ganze Problem hält, optimiert die falsche Stufe.
- Die vier Stufen Recherche und Briefing, Entwurf, Prüfung sowie Veröffentlichung und Feedback-Erfassung sind eine feste Abfolge mit ausdrücklichen Eingangs- und Ausgangskriterien an jeder Schnittstelle und keine lose Sammlung empfohlener Tätigkeiten.
- Jede Stufe hat eine namentlich benannte verantwortliche Person, eine definierte Rolle der KI und deterministische Kontrollen, die nicht davon abhängen, dass jemand daran denkt, sie von Hand anzuwenden.
- Die Feedback-Erfassung ist die Stufe, die die meisten Systeme auslassen. Sie macht aus einem einmaligen Produktionsprozess ein System, das sich mit jedem Zyklus verbessert, statt jedes Mal bei null zu beginnen.
- Eine minimal tragfähige Version dieses Systems lässt sich schnell aufsetzen. Eine ausgereifte Version erfordert gezielte Investitionen in Wissensinfrastruktur, Messung und Capability Transfer.
Definition und Rolle in der Kategorie
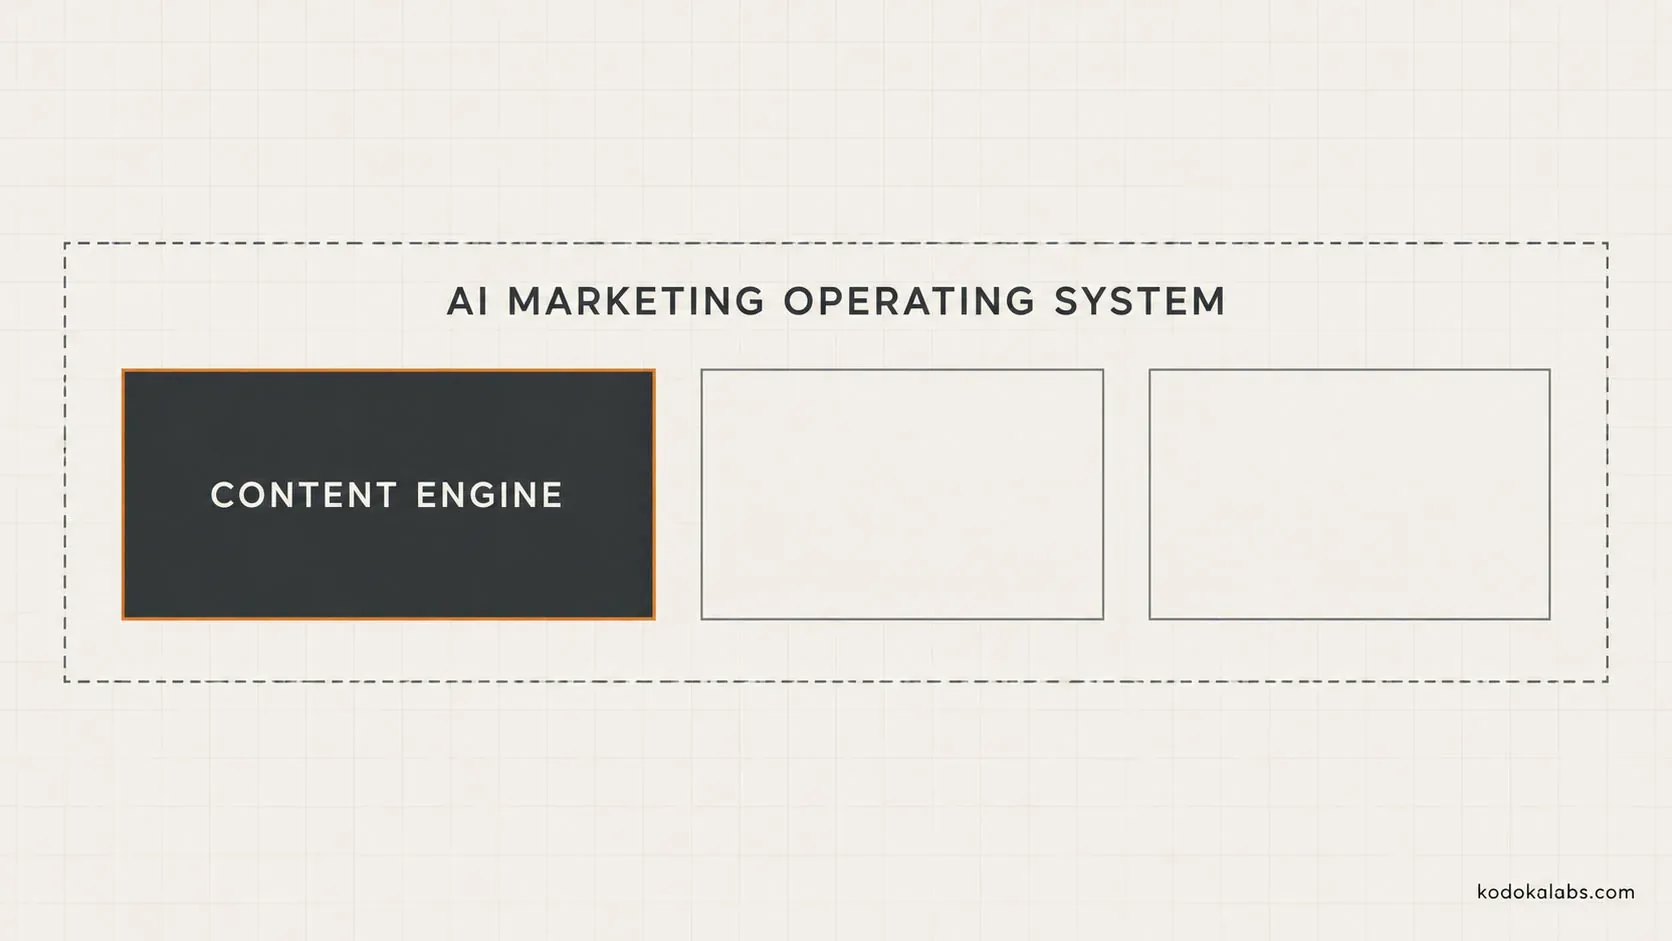
Das AI Editorial Operating System ist das vollständige, gesteuerte Produktionsmodell, das einen freigegebenen Content-Bedarf in vier verbundenen Stufen in ein veröffentlichtes, messbares Asset verwandelt: Recherche und Briefing, Entwurf, Prüfung sowie Veröffentlichung und Feedback-Erfassung. Es ist das operative Rückgrat dessen, was wir Content Engine nennen, also der Produktionsinfrastruktur innerhalb eines umfassenderen AI Marketing Operating System.
Entwerfen allein ist noch kein System. Ein Unternehmen, das ein leistungsfähiges KI-Entwurfstool eingeführt hat, aber weder einen definierten Recherche-Input noch ein durchgängiges Prüftor noch einen Mechanismus kennt, um festzuhalten, was funktioniert hat, hat eine Stufe der Produktion beschleunigt und den Rest unverändert gelassen. Genau das erzeugt den Prüfstau und die Markenverwässerung, die in den übrigen Inhalten dieser Website zur KI-Marketing-Transformation beschrieben sind. Das AI Editorial Operating System soll das verhindern: Es legt fest, was vor dem Entwurf geschieht und nachdem ein Entwurf freigegeben ist, und nicht nur, was im Entwurfsschritt selbst passiert.
Dieser Leitfaden ist die maßgebliche Vertiefung zu diesem Vier-Stufen-Modell. Die Governance-Richtlinie, also die Entscheidungsrechte und Risikostufen, die für alle vier Stufen gelten, behandelt AI Editorial Governance. Die konkrete Durchführung einer Prüfung beschreibt Human Review for AI Content. Kapazitäten, Warteschlangen und Übergaben, die mehrere Workflows im Maßstab verbinden, behandelt Content Supply Chain. Dieser Leitfaden zeigt, wie ein einzelner Inhalt das System von Anfang bis Ende durchläuft. Die anderen gehen tiefer auf einzelne Stufen und übergreifende Fragen des Systems ein.
 KI-generiert Bild
Gestaltungsprinzipien
Vier Prinzipien prägen den Aufbau dieses Betriebssystems. Kanonisches Wissen heißt: Recherche, freigegebene Fakten und Markenstandards liegen in einem definierten, referenzierbaren Leitsystem und nicht im Kopf Einzelner oder in verstreuten Dokumenten, sodass jede Entwurfsaufgabe auf dieselbe geprüfte Grundlage zugreift, statt sie jedes Mal neu zu rekonstruieren. Ausdrückliche Verträge heißt: Jede Stufe hat definierte Eingangskriterien, erforderliche Eingaben, erwartete Ergebnisse und Abnahmenachweise, sodass eine Übergabe zwischen den Stufen ein überprüfbarer Übergang ist und kein informelles „Ich glaube, das ist fertig“. Menschliche Verantwortung heißt: KI-Unterstützung beschleunigt einzelne Aufgaben innerhalb jeder Stufe, aber eine namentlich benannte Person entscheidet an jeder Stufengrenze über das Weitergehen. Die KI trifft nie eine Entscheidung über den Stufenabschluss. Feedback als wachsender Wert heißt: Was das Unternehmen in einem Produktionszyklus lernt, etwa welche Quellen verlässlich waren, welche Entwurfsmuster starke Überarbeitung brauchten und welche veröffentlichten Beiträge gut abschnitten, wird zu strukturiertem Input für den nächsten Zyklus und verschwindet nicht, sobald ein Inhalt live ist.
Diese Prinzipien beantworten eine Frage, die in den meisten Gesprächen über KI-gestützte Content-Produktion früh auftaucht: Warum die KI nicht einfach schneller entwerfen lassen und sich um den Rest später kümmern? Weil dieser „Rest“, also die Recherchegrundlage, die Prüfdisziplin und die Feedbackschleife, kein verzichtbarer Aufwand neben der eigentlichen Arbeit ist. Er entscheidet darüber, ob schnelleres Entwerfen mehr Wert erzeugt oder nur mehr Menge. Ein System, das ausschließlich auf Entwurfsgeschwindigkeit optimiert ist, verschiebt seinen Engpass mit mathematischer Sicherheit in die nachgelagerte Stufe, die nicht schneller geworden ist, fast immer die Prüfung. Die Wirkung auf Gesamtdurchlaufzeit und Content-Qualität ist dann häufig negativ, obwohl sich der Entwurfsschritt selbst messbar verbessert hat.
Recherche und Briefing
In Recherche und Briefing wird aus einem Content-Bedarf ein klar beschriebener, durch Belege gestützter Auftrag. Die Stufe beginnt mit der Quellenklärung: Was ist bereits bekannt, was muss neu recherchiert werden, und welche Aussagen müssen verifiziert sein, bevor sich ein Entwurf darauf stützen darf? Das knüpft unmittelbar an die Nachweisdisziplin an, die in AI Research Workflows beschrieben ist und auf die sich diese Stufe stützt, statt sie zu doppeln.
Die Stufe liefert ein Content-Briefing mit Absicht, Zielgruppe, benötigten Entitäten und Konzepten, Quellenmaterial, Risikostufe (gemäß AI Editorial Governance) und allen gesperrten Fakten, denen der Entwurf nicht widersprechen darf. KI-Unterstützung ist in dieser Stufe bei Recherche und Ordnung wirklich wertvoll: Sie findet vorhandenes Material, fasst Quellendokumente zusammen und entwirft eine erste Struktur zur menschlichen Prüfung. Die Entscheidung darüber, welche Quellen maßgeblich sind, welche Aussagen tragend sind und worauf das Briefing die Entwurfsstufe tatsächlich festlegt, bleibt jedoch eine menschliche.
Das Ausgangskriterium dieser Stufe ist ein freigegebenes Briefing mit angehängten Belegen und nicht bloß die Zuweisung eines Themas. Ein Briefing, das lautet „Schreiben Sie über KI-Governance“, hat diese Stufe nicht verlassen. Eines, das die zentralen Aussagen, ihre Quellen, den Entscheidungskontext der Zielgruppe und die Risikostufe festlegt, hat es. Content, der ohne ein ordnungsgemäß abgeschlossenes Briefing in den Entwurf geht, ist die häufigste Einzelursache für Nacharbeit später im System, weil die Textenden oder der Entwurfs-Workflow dann Recherche- und Umfangsentscheidungen treffen müssen, die früher hätten fallen sollen, meist unter größerem Zeitdruck und ohne dieselbe Nachweisdisziplin.
Ein ordnungsgemäß abgeschlossenes Briefing macht außerdem die KI-Unterstützung im Entwurf deutlich sicherer, weil es den Raum der Aussagen einengt, die der Entwurfs-Workflow einführen darf. Dieser Effekt wächst über die Geschichte eines Content-Programms: Ein Unternehmen mit einer reifen Bibliothek freigegebener Briefings und ihrer Belege kann den Rechercheaufwand für eine neue Anfrage oft weitgehend aus dem bereits Verifizierten decken und echten Neuaufwand für die Lücke reservieren, die ein neuer Beitrag tatsächlich aufmacht. Eine Entwurfsaufgabe, die auf einem Briefing mit drei verifizierten Statistiken, zwei definierten Entitäten und einer ausdrücklichen Umfangsgrenze beruht, hat kaum Spielraum, eine ungeprüfte Aussage einzuführen, ohne dass sie als Zusatz über das Briefing hinaus auffällt, was die Prüfung gezielt kontrollieren kann. Eine Entwurfsaufgabe, die von einer vagen Themenzuweisung ausgeht, hat keine solche Grenze, und ein Modell, das diese Lücke mit plausiblem Allgemeinwissen füllt, verhält sich genau wie vorgesehen: Die fehlende Grenze ist die eigentliche Ursache des Risikos, nicht ein Fehler des Modells.
Recherche und Briefing bestimmt auch, wie stark das Wissen des Unternehmens über die Zeit wächst. Ein Briefing, das vollständig aus einer einmaligen Suchsitzung entsteht, ergibt einen einmaligen Inhalt. Ein Briefing, das zuerst die eigene Wissensdatenbank des Unternehmens prüft und erst danach die echten Lücken recherchiert, entsteht nicht nur schneller, sondern führt alles neu Verifizierte in diese Wissensdatenbank zurück, für den nächsten Beitrag, der es braucht. Das ist die erste von mehreren Stellen im System, an denen sich entscheidet, ob Recherche als Wegwerfarbeit pro Beitrag oder als wachsendes Unternehmensvermögen behandelt wird, und damit, ob das System sich verstärkt oder nur wiederholt.
Entwurf
Der Entwurf verwandelt ein freigegebenes Briefing in eine strukturierte erste Fassung des Inhalts. In dieser Stufe bringt generative KI den unmittelbarsten Geschwindigkeitsgewinn, und sie ist zugleich die Stufe, die am ehesten fälschlich für das gesamte Produktionssystem gehalten wird.
Die Zerlegung in Aufgaben auf Abschnittsebene funktioniert besser, als einen einzigen Entwurfsdurchlauf einen ganzen langen Inhalt auf einmal erzeugen zu lassen. So lassen sich die Aussagen und die Struktur jedes Abschnitts genauer gegen die gesperrten Fakten und Belege des Briefings prüfen, und das Risiko sinkt, dass die interne Konsistenz des Modells über eine sehr lange Ausgabe in einem Zug driftet. Kontextisolierung ist aus demselben Grund wichtig: Eine Entwurfsaufgabe sollte das konkrete, freigegebene Quellenmaterial für ihren Abschnitt erhalten und nicht die offene Anweisung, „aufzuschreiben, was man dazu weiß“, die das Modell einlädt, Lücken mit plausiblem, aber ungeprüftem Allgemeinwissen zu füllen.
Zulässige Aussagen sind durch das Briefing aus Recherche und Briefing begrenzt. Der Entwurf ist kein zweiter Recherchedurchgang, und ein Entwurf, der eine neue Tatsachenbehauptung über das Briefing hinaus einführt, sollte diese Aussage ausdrücklich für die Prüfung markieren und sie nicht mit derselben Sicherheit präsentieren wie einen vorab verifizierten Fakt. Die Versionierung sollte in dieser Stufe beginnen und nicht erst rückwirkend bei der Veröffentlichung, damit sich später nachvollziehen lässt, wie ein Beitrag vom Briefing zum veröffentlichten Asset gewachsen ist, statt dies hinterher aus dem Gedächtnis zu rekonstruieren.
Stil und Tonalität sind eine Aufgabe der Entwurfsstufe, die sich gegenüber der inhaltlichen Richtigkeit leicht unterschätzen lässt, aber auf eigene Weise Wirkung entfaltet: Ein Entwurfs-Workflow, der die gewünschte Stimme des Unternehmens verlässlich trifft, verkürzt die Prüfzeit für Zeilenkorrekturen und schafft Aufmerksamkeit für die inhaltlichen und strukturellen Prüfungen, die tatsächlich Risiko tragen. Das ist einer der klareren Fälle, in denen sich die Investition in die Eingaben der Entwurfsstufe, einen dokumentierten Styleguide und eine Reihe freigegebener Stimmbeispiele, im weiteren Verlauf wiederholt auszahlt und nicht bloß einmalige Einrichtungskosten ist.
Ebenso wichtig ist, was man vom Entwurf nicht verlangen sollte. Er sollte nicht die Stufe sein, in der der Umfang entschieden wird, in der uneindeutiges Quellenmaterial geklärt wird oder in der das spätere Urteil der Prüfung vorweggenommen wird, indem jeder Satz abgesichert wird. Ein Entwurf, der jede Aussage abschwächt, um Einwänden in der Prüfung zu entgehen, ist nicht sicherer, sondern verlagert nur die Arbeit, zu entscheiden, was der Beitrag eigentlich behauptet, auf die Lesenden. Das ergibt vagen, wenig überzeugenden Content, selbst wenn jeder einzelne Satz formal vertretbar ist.
Prüfung
Die Prüfung testet den Entwurf gegen die Abnahmekriterien seiner Risikostufe, wie in AI Editorial Governance festgelegt. Die konkrete Durchführung, also Zuweisung der Prüfenden, Fehlertaxonomie und Evidence Packs, beschreibt Human Review for AI Content ausführlich. Dieser Leitfaden konzentriert sich darauf, wie die Prüfung in die Vier-Stufen-Abfolge passt, und wiederholt diese Details nicht.
Eine vollständige Prüfung umfasst je nach Risikostufe typischerweise mehrere Dimensionen: fachliche Richtigkeit gegen die gesperrten Aussagen und Quellen des Briefings, Markenstimme und Treue zum Framework (verwendet der Beitrag etwa die kanonischen Namen von kōdōkalabs korrekt?), strukturelle sowie Such- und GEO-Qualität, Barrierefreiheit und bei sensiblem Content die Freigabe durch juristische oder Compliance-Fachleute. Automatisierte Prüfungen wie Rechtschreibung und Grammatik, Erkennung defekter Links und einfache Schema-Validierung können und sollten laufen, bevor ein Mensch den Entwurf zu sehen bekommt, damit die menschliche Prüfzeit in Urteilsentscheidungen fließt und nicht in Fehler, die ein deterministisches Werkzeug zuerst hätte finden können. Diese Prüfungen früher in der Pipeline auszuführen, noch bevor ein Entwurf an eine prüfende Person geht, verkürzt zudem die Gesamtdurchlaufzeit, denn ein Entwurf, der an einer einfachen automatisierten Kontrolle scheitert, kann sofort zur Korrektur zurückgehen, statt in der Warteschlange zu liegen, bis jemand ihn zufällig öffnet.
Das Ausgangskriterium dieser Stufe ist eine konkrete, festgehaltene Entscheidung: freigegeben, mit kleinen Änderungen freigegeben, zur inhaltlichen Überarbeitung zurückgegeben oder eskaliert. Ein Entwurf, der informell mit vagem Feedback kursiert und veröffentlicht wird, sobald „niemand mehr widerspricht“, hat diese Stufe nicht mit einer echten Entscheidung verlassen, und damit fehlt jeder abrufbare Nachweis, was geprüft wurde, wenn später Fragen zur Freigabe des Beitrags auftauchen.
Die Prüftiefe sollte zur Risikostufe aus Recherche und Briefing passen und nicht je nachdem nach oben oder unten driften, wie ausgelastet die prüfende Person in dieser Woche gerade ist. Das Briefing selbst und nicht das Urteil der prüfenden Person im Augenblick sollte festhalten, was diese Tiefe tatsächlich verlangt. Wer unter Termindruck bei einem sensiblen Beitrag stillschweigend weniger genau hinsieht, hat die tatsächliche Prüfstrenge unter das gesenkt, was die Risikoklassifizierung verlangt, obwohl sich am formalen Prozess nichts geändert hat. Deshalb sind automatisierte Vorprüfungen so wichtig: Sie greifen unabhängig von Arbeitslast und Zeitdruck konsequent und fangen eine Grundmenge an Problemen ab, bevor menschliches Urteil überhaupt gefragt ist.
Eine gut funktionierende Prüfung liefert dem restlichen System außerdem nützliche Signale und nicht nur ein Bestanden/Nicht bestanden für den Beitrag vor ihr. Ein Befundmuster, etwa dass Entwürfe einer bestimmten Content-Kategorie immer wieder dieselbe Art von Überarbeitung brauchen, belegt, dass vorgelagert etwas angepasst werden muss: die Briefing-Vorlage, das freigegebene Quellenmaterial oder die Konfiguration des Entwurfs-Workflows. Es belegt nicht, dass die Prüfung bei jedem Einzelbeitrag härter arbeiten müsste. Wiederkehrende Befunde als Systemsignal zu behandeln und nicht als Ärgernis im Einzelfall, verbindet die Prüfung mit der Feedback-Erfassung, die als Nächstes beschrieben wird.
Veröffentlichung und Feedback-Erfassung
Die Veröffentlichung ist der technische Akt, freigegebenen Content mit korrekt konfigurierten Metadaten, Schema und internen Links in das Content-Management-System zu bringen, nach der in der Prüfung festgehaltenen abschließenden Freigabe. Zur Stufe gehört ein QA-Durchgang vor der Veröffentlichung, der bestätigt, dass das, was live gehen soll, mit dem tatsächlich Freigegebenen übereinstimmt, denn eine Formatierungsänderung in letzter Minute oder eine versehentlich zurückgesetzte Änderung zwischen Freigabe und Veröffentlichung ist in Content-Systemen ganz allgemein ein realer, wiederkehrender Fehlerfall.
Die Feedback-Erfassung ist der Teil dieser Stufe, den die meisten Content-Abteilungen auslassen, und sie ist für die „wachsende“ Hälfte der Grundidee dieses Leitfadens zuständig. Ist ein Beitrag veröffentlicht, werden seine Performance, seine Suchsichtbarkeit, die Häufigkeit von Zitaten in KI-Antwortsystemen, das Engagement und der Beitrag zur Conversion zu Daten, die das System erfassen und in künftige Entscheidungen bei Recherche und Briefing zurückspielen sollte. Genauso wichtig ist operatives Feedback: Welche Quellen sich als unzuverlässig erwiesen, welche Entwurfsmuster regelmäßig starke Überarbeitung brauchten und welche Aussagen die meiste Reibung in der Prüfung erzeugten, sollte in die kanonische Wissensdatenbank und die Briefing-Vorlagen des Unternehmens zurückfließen und nicht nur im Gedächtnis derjenigen bleiben, die den jeweiligen Beitrag betreut haben.
Ohne diese Feedbackschleife beginnt jeder Content-Zyklus nahe null und wiederholt dieselben Recherchelücken und dieselben Schwächen im Entwurf auf unbestimmte Zeit. Mit ihr verringern die Erkenntnisse jedes Zyklus messbar die Nacharbeit des nächsten. Das ist der tatsächliche Mechanismus hinter der Aussage, dass ein gesteuertes System sich verstärkt und nicht nur beschleunigt, und kein Slogan.
Zwei unterschiedliche Arten von Feedback sollten erfasst werden, denn sie zu vermischen kostet Information. Performance-Feedback beantwortet, ob der veröffentlichte Inhalt seinen Zweck erfüllt hat: Hat er gerankt, wurde er von einem Antwortsystem zitiert, hat er das Engagement oder die Conversion erzeugt, für die er beauftragt wurde? Operatives Feedback beantwortet, ob der Produktionsprozess selbst gut funktioniert hat: wie viel Überarbeitung der Entwurf brauchte, welche Quellen der Prüfung standhielten und wo Prüfende ungewöhnlich lange brauchten oder ungewöhnliche Bedenken äußerten. Performance-Feedback bestimmt vor allem, was als Nächstes erstellt wird. Operatives Feedback bestimmt vor allem, wie es besser erstellt wird. Ein System, das nur Performance-Feedback erfasst, wiederholt denselben ineffizienten Produktionsprozess auf unbestimmte Zeit, auch wenn es bei der Themenwahl besser wird.
Rollen, Systeme und Ausnahmen
Jede Stufe braucht eine namentlich benannte verantwortliche Person: eine Recherche- oder Briefing-Leitung für Recherche und Briefing, eine Textende oder die Verantwortung für den Entwurfs-Workflow für den Entwurf, eine zur Risikostufe passende Prüfung für die Prüfung und eine Veröffentlichungs- oder Content-Operations-Verantwortung für Veröffentlichung und Feedback-Erfassung. Die Leitsysteme sollten ausdrücklich benannt und nicht vorausgesetzt werden: eine Wissensdatenbank oder ein Quellenregister für freigegebene Recherche, ein Content-Management-System mit Versionskontrolle für Entwürfe, ein Prüf- und Freigabeprotokoll für Entscheidungen und ein Analyse- und Zitationsmonitoring für die Feedbackdaten.
Ausnahmen, etwa ein Briefing, das mitten im Entwurf aktualisiert werden muss, weil neue Informationen aufgetaucht sind, oder ein Prüfbefund, der den Inhalt bis zu Recherche und Briefing zurückschickt statt zu einer einfachen Überarbeitung, brauchen einen definierten Weg zurück in die passende Stufe und sollten nicht informell in der Stufe geflickt werden, in der sich der Inhalt gerade befindet. Ein Flicken in der Entwurfsstufe, der eine in der Prüfung entdeckte Recherchelücke überdeckt, ergibt oft Content, der an der Oberfläche erledigt aussieht und stillschweigend eine ungeprüfte Aussage weiterträgt.
Die Rollengestaltung gewinnt mit steigendem Volumen an Bedeutung. Eine einzige Person kann bei einem Unternehmen, das nur eine Handvoll Beiträge im Monat veröffentlicht, plausibel alle vier Stufenrollen innehaben, und das Hauptrisiko besteht dann lediglich darin, dass die Rollen informell bestehen und nicht benannt sind. Mit wachsendem Volumen wird es zur strukturellen Absicherung, diese Rollen zu trennen oder zumindest sicherzustellen, dass die Prüfung nie bei der Person liegt, die den Beitrag entworfen hat, denn Menschen sind gegenüber der eigenen Arbeit naturgemäß weniger kritisch als gegenüber der anderer. Unternehmen, die gezielt expertengetriebenen Content skalieren, bei dem die Zeit der Fachexpertinnen und -experten die knappste Ressource im System ist, müssen sorgfältig abwägen, welche dieser vier Rollen die Fachperson selbst halten muss und welche sich an eine geschulte redaktionelle Vertretung delegieren lassen. Diese Frage wird in Scaling Expert-Led Content Without Diluting Expertise ausführlich behandelt.
Die folgende Tabelle legt den Betriebsvertrag jeder der vier Stufen vollständig fest.
| Stufe | Zweck | Eingangskriterien | Eingaben | Verantwortliche Person | Rolle der KI | Deterministische Kontrollen | Ergebnis | Abnahmenachweis | Ausnahmeweg | Ausgangskriterien |
|---|---|---|---|---|---|---|---|---|---|---|
| Recherche und Briefing | Einen Content-Bedarf in einen klar beschriebenen, durch Belege gestützten Auftrag überführen | Freigegebener Content-Bedarf mit benannter Verantwortung | Thema, Zielgruppe, vorhandene Wissensdatenbank, Hinweise zur Risikostufe | Recherche- oder Briefing-Leitung | Recherche, Zusammenfassung, Strukturentwurf | Prüfung der Quellenhierarchie, Prüfung der Risikostufenzuweisung | Freigegebenes Content-Briefing mit angehängten Belegen | Freigabevermerk zum Briefing | Rückgabe an die Content-Verantwortung zur Klärung des Umfangs | Briefing mit gesperrten Fakten freigegeben, Risikostufe zugewiesen |
| Entwurf | Eine strukturierte erste Fassung innerhalb der Grenzen des Briefings erstellen | Freigegebenes Briefing | Briefing, gesperrte Fakten, freigegebenes Quellenmaterial | Textende oder Verantwortung für den Entwurfs-Workflow | Entwurf einzelner Abschnitte, Struktur, stilistische Konsistenz | Prüfung der Aussagengrenze gegen das Briefing, Versionsprotokoll | Versionierter Entwurf | Entwurfsversion mit angehängten Quellen der Aussagen | Rückgabe an Recherche und Briefing bei Lücke in Umfang oder Belegen | Entwurf vollständig und in sich stimmig mit dem Briefing |
| Prüfung | Den Entwurf gegen die Abnahmekriterien der Risikostufe testen | Vollständiger Entwurf | Entwurf, Briefing, Risikostufe, Abnahmekriterien | Zur Risikostufe passende Prüfung | Automatisierte Prüfungen, Entwurfshilfe für Überarbeitungen | Automatisierte QA-Prüfungen, Fehlerprotokoll | Geprüfter und entschiedener Entwurf | Dokumentierte Prüfbefunde und Entscheidung | Rückgabe an den Entwurf zur Überarbeitung oder an Recherche und Briefing bei Belegslücke | Ausdrückliche Entscheidung (freigeben, überarbeiten oder eskalieren) festgehalten |
| Veröffentlichung und Feedback-Erfassung | Freigegebenen Content veröffentlichen und Erkenntnisse zu Performance und Betrieb erfassen | Freigegebener, entschiedener Entwurf | Freigegebener Entwurf, Metadaten, Schema, Zugriff auf Analytics | Veröffentlichungs- oder Content-Operations-Verantwortung | Unterstützung bei Metadaten und Schema, Zusammenfassung der Performance | QA-Abgleich vor der Veröffentlichung, terminierte Performance-Prüfung | Veröffentlichtes Asset plus Feedback-Eintrag | Veröffentlichungsprotokoll und Eintrag im Feedback-Log | Korrekturweg nach der Veröffentlichung bei wesentlichen Fehlern | Veröffentlicht, überwacht, Feedback in das kanonische Wissen übernommen |
Reifegrad und Umsetzungsfahrplan
Eine minimal tragfähige Version dieses AI Editorial Operating System ist ohne große Vorabinvestition erreichbar: eine gemeinsame Briefing-Vorlage, die Risikostufe und Quellenangabe erzwingt, eine einzige festgelegte Prüfung pro Risikostufe und ein einfaches Protokoll, was wann veröffentlicht wurde. Allein das schließt den Großteil der Lücke zwischen ungesteuertem KI-Entwurf und einem System mit echter Verantwortung an jeder Stufengrenze.
Eine ausgereifte Version ergänzt eine strukturierte Wissensinfrastruktur (eine echte Wissensdatenbank statt eines Ordners voller Dokumente), systematische automatisierte QA vor der menschlichen Prüfung, eine funktionierende Feedbackschleife, die die Nacharbeit von Zyklus zu Zyklus messbar senkt, und einen dokumentierten Capability Transfer, sodass das System auf institutionellem Prozess läuft und nicht auf der persönlichen Disziplin von ein oder zwei Personen. Der folgende Vergleich macht den Unterschied zwischen beiden Zuständen greifbar.
| Dimension | Minimal tragfähiges System | Ausgereiftes System |
|---|---|---|
| Recherche-Input | Quellensammlung nach Bedarf pro Beitrag | Strukturierte Wissensdatenbank mit Quellenhierarchie und Claim Register |
| Briefing | Schlanke Briefing-Vorlage mit Risikostufe | Vollständiges Briefing mit gesperrten Fakten, Entitäten und angehängten Belegen |
| Entwurf | KI-Entwurf in einem Durchlauf mit manueller Kontrolle | Zerlegung in Aufgaben auf Abschnittsebene mit Kontextisolierung und Versionierung |
| Prüfung | Eine prüfende Person, informelle Freigabe | Zur Risikostufe passende Prüfende, automatisierte Vorprüfungen, dokumentierte Fehlernachweise |
| Veröffentlichung | Manuelle Eingabe der Metadaten | Automatisierte Erzeugung von Metadaten und Schema mit QA-Abgleich vor der Veröffentlichung |
| Feedback-Erfassung | Gelegentliche informelle Retrospektive | Strukturiertes Performance- und operatives Feedback, das in künftige Briefings einfließt |
| Verantwortung | Auf ein oder zwei Personen konzentriert | Dokumentiert, geschult und über benannte Rollenverantwortliche übertragbar |
Die meisten Unternehmen sollten nicht versuchen, das ausgereifte System in einem Schritt aufzubauen. Ein gestufter Rollout, bei dem die Vier-Stufen-Struktur an einer einzelnen Content-Kategorie pilotiert wird, Durchlaufzeit und Nacharbeit gemessen werden und Wissensinfrastruktur und Automatisierung erst ausgebaut werden, wenn die Disziplin der Grundstufen funktioniert, führt meist zu einem System, das tatsächlich genutzt wird, und nicht zu einem, das auf dem Papier existiert und unter Termindruck umgangen wird.
Die Reihenfolge beeinflusst auch, wie schnell das System beginnt, sich zu verstärken. Teams, die an einer einzigen, klar abgegrenzten Content-Kategorie pilotieren, bauen für diese Kategorie meist innerhalb weniger Zyklen eine funktionierende Wissensdatenbank und eine abgestimmte Briefing-Vorlage auf, und das ist ein Beleg, auf den sie sich beim Ausbau auf eine zweite Kategorie berufen können. Teams, die vom ersten Tag an alle Content-Kategorien gleichzeitig angehen, haben am Ende meist eine flache, generische Version des Systems, die überall angewendet wird und den Kontakt mit dem ersten wirklich schwierigen Stück sensiblen Contents selten übersteht. Ein engerer, tieferer Pilot ist meist der schnellere Weg zu einem System, dem so weit vertraut wird, dass man es ausbaut.
Die Wahl der ersten Pilotkategorie verdient eigene Überlegung und sollte nicht einfach auf das Team fallen, das gerade am meisten Lust auf Neues hat. Eine gute erste Kategorie hat ein hinreichend hohes Volumen, sodass das Team in einem überschaubaren Zeitraum mehrere vollständige Zyklen durchläuft und die Feedbackschleife eine echte Chance hat, ihren Wert zu zeigen, aber ein nicht so hohes Risiko, dass eine anfängliche, zu erwartende holprige Phase des neuen Prozesses unverhältnismäßige Folgen hat. Eine Routine- oder „wesentliche“ Kategorie, die das Unternehmen regelmäßig produziert, ist meist der richtige Ort, um das Modell zu beweisen, bevor man es auf den Content mit den höchsten Risiken ausdehnt, statt mit dem sensibelsten Content zu beginnen.
Typische Fehlerbilder
Das häufigste Fehlerbild ist ein Tool-first-Ansatz: Ein Unternehmen führt ein leistungsfähiges KI-Entwurfstool ein und hält diese Einführung für das AI Editorial Operating System, ohne Recherche-Input oder Prüfergebnis darum herum zu definieren. Das ergibt schnellere Entwürfe und meist schon nach wenigen Zyklen einen Prüfstau, der den Geschwindigkeitsgewinn wieder aufzehrt. Ein zweites Fehlerbild ist eine Feedback-Erfassung, die nur dem Namen nach besteht: ein vierteljährliches Retrospektiven-Meeting, das Diskussionen auslöst, aber keine strukturierte Änderung an Briefing-Vorlage, Wissensdatenbank oder Prüfcheckliste bewirkt. Ein drittes ist die Erosion der Stufengrenzen: Unter Termindruck beginnt der Entwurf, bevor ein Briefing tatsächlich freigegeben ist, oder die Veröffentlichung erfolgt, bevor die Prüfung formal mit einer Entscheidung abgeschlossen ist. Das macht aus einem gesteuerten System stillschweigend wieder ein ungesteuertes, das nur denselben Namen trägt.
Häufig gestellte Fragen
Ist das dasselbe wie ein Redaktionsplan oder ein redaktionelles Workflow-Tool, das Sie bereits haben?
Nein. Ein Redaktionsplan legt fest, wann etwas geschieht. Dieses Betriebssystem definiert, was gelten muss, nämlich bestimmte Eingaben, bestimmte menschliche Freigaben und bestimmte Belege, damit Content legitim von einer Stufe in die nächste wechseln darf. Beides kann und sollte zusammenarbeiten, aber ein Redaktionsplan allein liefert nichts von der Verantwortungs- und Nachweisstruktur, die dieser Leitfaden beschreibt.
Muss jeder Inhalt, den Sie produzieren, alle vier Stufen in voller Tiefe durchlaufen?
Ja, in der Abfolge, aber die Tiefe innerhalb jeder Stufe richtet sich nach der Risikostufe gemäß AI Editorial Governance. Ein routinemäßiges internes Update durchläuft alle vier Stufen zügig und leicht, eine sensible öffentliche Aussage dieselben vier Stufen mit deutlich mehr Sorgfalt in jeder.
Worin unterscheidet sich dieser Leitfaden von Content Supply Chain?
Dieser Leitfaden definiert, wie ein einzelner Inhalt die vier kanonischen Stufen durchläuft. Content Supply Chain behandelt, was geschieht, wenn viele Inhalte gleichzeitig durch das System laufen: Kapazität, Warteschlangen, Abhängigkeiten, Servicelevel und Ausfallsicherheit über die gesamte Produktion.
Wie lange dauert es, eine minimal tragfähige Version dieses Systems aufzusetzen?
Die meisten Content-Organisationen können die oben beschriebene minimal tragfähige Version innerhalb weniger Wochen umsetzen, denn sie braucht eine Briefing-Vorlage, eine benannte Prüfung pro Risikostufe und ein einfaches Veröffentlichungsprotokoll und keine neue Technologie. Die ausgereifte Version ist ein längerfristiger Kompetenzaufbau, in der Regel in Monaten zu messen, weil sie von Wissensinfrastruktur und einer funktionierenden Feedbackschleife abhängt, die mehrere echte Zyklen zum Reifen braucht.
Können Sie die KI die gesamte Entwurfsstufe übernehmen lassen, ohne dass vor der Prüfung ein Mensch den Entwurf anfasst?
Ja, für die meisten Risikostufen, sofern das Briefing ordnungsgemäß mit gesperrten Fakten und Belegen abgeschlossen wurde und die Prüfung ein verpflichtendes, nicht überspringbares Tor vor der Veröffentlichung bleibt. Fehlende menschliche Beteiligung im Entwurf ist nicht dasselbe wie fehlende menschliche Verantwortung für das Veröffentlichte.
Wie verändert die Feedback-Erfassung Ihre künftigen Briefings konkret?
Operatives Feedback, also welche Quellen unzuverlässig waren und welche Aussagearten die meiste Überarbeitung brauchten, fließt direkt in Wissensdatenbank und Briefing-Vorlage: Eine Quelle, die wiederholt strittige Aussagen hervorbrachte, wird markiert oder aus der freigegebenen Quellenhierarchie entfernt, und eine Aussageart, die durchgängig intensive Prüfung brauchte, bekommt für künftige Briefings dieser Kategorie einen ausdrücklichen Punkt in der Checkliste. So steckt die Erkenntnis im System und wird nicht nur informell von denen erinnert, die zufällig beteiligt waren.
Wo dieses System hineingehört
Dieser Leitfaden definiert den vollständigen Produktionskreislauf. Für die Governance-Richtlinie, die Risikostufen und Entscheidungsrechte über alle vier Stufen festlegt, siehe AI Editorial Governance. Für die konkrete Durchführung der Prüfung siehe Human Review for AI Content. Dafür, wie sich dieses System über viele gleichzeitige Workflows skaliert, siehe Content Supply Chain. Unternehmen, die einschätzen wollen, wie reif ihre aktuelle Content-Produktion gegenüber diesem Vier-Stufen-Modell tatsächlich ist, können mit einem Executive AI Marketing Assessment von kōdōkalabs beginnen.