Die Content Supply Chain ist das Netzwerk aus Bedarfssignalen, Wissensinputs, Expertenkapazität, Produktionsstufen, Systemen, Übergaben, Freigaben, Distributionswegen und Feedbackschleifen, das nötig ist, um Arbeit von einem begründeten Bedarf bis zu einem gepflegten, veröffentlichten Asset zu bringen. Content ist keine Massenware. Aber die Warteschlangen, Abhängigkeiten, Engpässe und Qualitäts-Gates, die ihn durch eine Organisation bewegen, sind operative Realität und verdienen ein bewusstes Design.
Die wichtigsten Erkenntnisse zur Content-Produktionseffizienz
- Effizienz ist nicht Volumen. Eine Organisation, die bei gleicher Qualitätslatte und gleicher Review-Kapazität doppelt so viel Content produziert, ist nicht zwangsläufig effizienter geworden. Möglicherweise hat sie ihren Engpass nur nach hinten verschoben.
- Flusskennzahlen wie Durchlaufzeit, Wartezeit, Work in Progress und First-Pass-Yield zählen mehr als reine Output-Zahlen, denn sie zeigen, wo die Zeit tatsächlich bleibt, und nicht nur, wie viel produziert wurde.
- Jede Effizienzkennzahl braucht eine Qualitäts- oder Wert-Leitplanke. Eine Kennzahl ohne Leitplanke wird früher oder später so optimiert, dass sie genau das beschädigt, was sie nie schützen sollte.
- Der eigentliche Engpass in den meisten KI-gestützten Content Operations hat sich vom Entwerfen zu Recherche, Review oder Verfügbarkeit von Fachleuten verlagert. Die Verbesserungsarbeit sollte dem Engpass folgen und nicht Annahmen darüber, wo er früher lag.
- Beim Entwerfen eingesparte Zeit ist nicht automatisch realisierter Geschäftswert. Die Lücke schließt sich erst, wenn die gewonnene Zeit tatsächlich in höherwertige Arbeit fließt oder Kosten wirklich senkt, statt in mehr Volumen derselben Art von Content zu verschwinden.
Definition und Korrektur der Messgrößen
Content-Produktionseffizienz ist die verlässliche Umwandlung freigegebener Inputs in wertvolle, publizierbare und wiederverwendbare Content-Assets mit möglichst wenig vermeidbarer Verzögerung, Nacharbeit, Risiko und Verschwendung. Sie ist ausdrücklich nicht dasselbe wie maximaler Output pro Person oder pro Euro. Beides zu verwechseln ist der häufigste Fehler, den wir in Organisationen sehen, sobald KI-Unterstützung schnelleres Entwerfen möglich macht.
Die Korrektur, die dieser Leitfaden vornimmt, ist konkret: KI verändert die Ökonomie der Content-Produktion über die einzelnen Stufen hinweg ungleichmäßig. Das Entwerfen kann dramatisch schneller werden, während Recherche, fachliches Review, Expertenverfügbarkeit und Freigabeprozesse genauso begrenzt bleiben wie zuvor. Ein Messsystem, das nur die Entwurfsgeschwindigkeit erfasst oder das Gesamtvolumen als wichtigstes Effizienzsignal behandelt, verfehlt das zuverlässig. Es feiert eine Verbesserung auf der Entwurfsstufe, die sich, Ende zu Ende gemessen, weder schneller noch besser ausgewirkt hat.
Dieser Leitfaden knüpft direkt an das Vier-Stufen-Modell des AI Editorial Operating System und an die Kapazitäts- und Resilienzsicht der Content Supply Chain an. Wo diese Leitfäden definieren, wie Content durch das System laufen soll, definiert dieser, wie sich messen lässt, ob er wirklich gut läuft, und was zu tun ist, wenn nicht. Das ist wichtig, weil eine Content-Organisation ihre Stufen korrekt ausführen und jeden definierten Vertrag einhalten und trotzdem insgesamt ineffizient sein kann, wenn niemand Fluss, Qualität und Kosten gemeinsam über das ganze System misst statt innerhalb einer einzelnen Stufe.
Den tatsächlichen Workflow abbilden
Bevor Sie irgendetwas messen, muss der Workflow so abgebildet werden, wie er wirklich abläuft, und nicht so, wie ihn die Dokumentation der Organisation beschreibt. Diese Abbildung sollte jede Warteschlange erfassen (wo Arbeit wartet, bevor jemand sie beginnt), jede Einheit tatsächlicher Arbeit (wo jemand oder etwas aktiv bearbeitet), jede Übergabe zwischen Rollen oder Systemen, jede Nacharbeitsschleife (wo Arbeit auf eine frühere Stufe zurückgeht) und jedes Qualitäts-Gate, das durchlaufen wird.
Die meisten Organisationen stellen beim ersten ehrlichen Mapping fest, dass ein erheblicher Teil der gesamten Laufzeit eines Contents mit Warten verbracht wird und nicht mit Bearbeiten. Das ist wichtig, denn Effizienzmaßnahmen, die nur auf die aktiven Arbeitsanteile zielen, etwa schnelleres Entwerfen oder kürzere Review-Checklisten, lassen die Wartezeit unberührt. In einem realen Content-Betrieb macht Wartezeit sehr oft den größeren Teil der Durchlaufzeit aus.
Ehrlich abzubilden heißt auch, der Versuchung zu widerstehen, den Prozess als saubere lineare Abfolge zu zeichnen, wenn die reale Version Schleifen, Ausnahmen und informelle Abkürzungen enthält. Eine Content-Anfrage, die aus der normalen Warteschlange herausgezogen wird, weil eine hochrangige Führungskraft sie direkt verlangt hat, gehört zum Workflow, auch wenn sie im dokumentierten Prozess nicht vorkommt. Sie verdrängt andere eingereihte Arbeit, und das sollte sichtbar sein, statt jedes Mal als unsichtbare Ausnahme behandelt zu werden. Das Ziel des Mappings ist keine saubere Grafik für eine Präsentation, sondern ein hinreichend genaues Bild, damit die Messarbeit im nächsten Abschnitt die Realität tatsächlich widerspiegelt.
Die Abbildung sollte auf direkter Beobachtung echter Arbeit beruhen und nicht allein auf Interviews darüber, wie Beteiligte den Prozess zu kennen glauben. Beide Versionen gehen zuverlässig auseinander, und zwar nicht aus Absicht: Menschen beschreiben den Prozess so, wie er entworfen wurde oder wie er zuletzt lief, als alles glatt ging, und nicht so, wie er in einer durchschnittlichen Woche mit Eilanfrage, fehlender Review-Kapazität oder einem Stück Content läuft, das zweimal zurückkam, bevor es durchging. Wer eine Handvoll Inhalte Zeitstempel für Zeitstempel durch das reale System verfolgt, deckt Lücken auf, die keine Befragung zum eigenen Workflow zuverlässig findet. Denn die Befragten beschreiben ihre Absicht für den Prozess und prüfen nicht detailliert ihre jüngste Erfahrung damit.
Fluss und Qualität messen
Flusskennzahlen und Qualitätskennzahlen müssen gemeinsam erfasst werden, nie getrennt voneinander. Die Durchlaufzeit (Cycle Time) misst die gesamte Zeit vom Eingang einer Content-Anfrage bis zur Veröffentlichung. Die Wartezeit (Queue Time) misst, wie lange Arbeit wartet, bevor jemand sie aktiv bearbeitet, getrennt von der Bearbeitungszeit (Touch Time), also der Zeit, die tatsächlich in die Arbeit fließt. Der Durchsatz (Throughput) misst, wie viel Content pro Zeitraum fertig wird. Work in Progress misst, wie viel Content gleichzeitig in der Pipeline aktiv ist. Das ist ein nützliches Frühwarnsignal: Steigt Work in Progress bei gleichbleibendem Durchsatz, deutet das meist auf einen entstehenden Engpass hin, noch bevor er als Lieferverzug sichtbar wird. Der First-Pass-Yield misst, welcher Anteil des Contents das Review ohne substanzielle Überarbeitung besteht, ein starker Indikator dafür, wie gut die vorgelagerten Stufen, Briefing und Entwurf, tatsächlich arbeiten. Fehler- und Nacharbeitsquoten messen, wie oft Content zurückgeschickt werden muss und warum. Sie zeigen direkt, wo Qualitätsprobleme entstehen, und nicht nur, wo sie entdeckt werden.
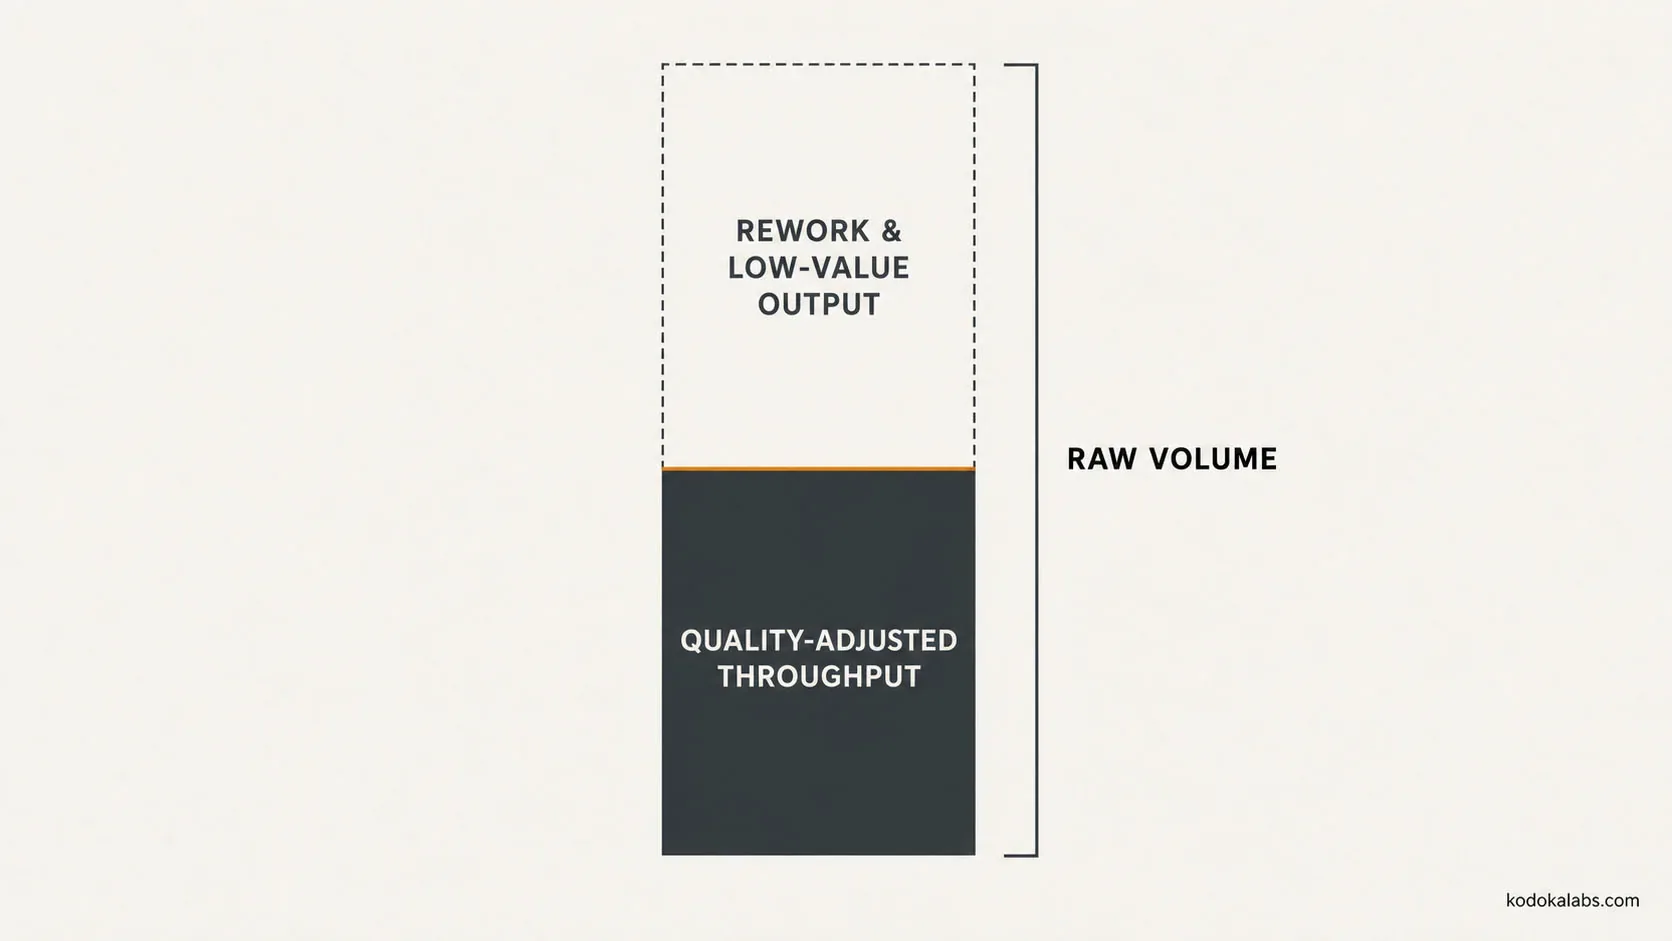
Jede dieser Kennzahlen braucht eine ausdrückliche Leitplanke, denn eine isoliert verfolgte Flusskennzahl wird früher oder später ausgereizt, oft unabsichtlich, und zwar so, dass sie beschädigt, was sie nicht erfassen sollte. Eine Verkürzung der Durchlaufzeit ohne Qualitäts-Leitplanke wird irgendwann dadurch erreicht, dass die Review-Tiefe sinkt. Eine Steigerung des Durchsatzes ohne Wert-Leitplanke wird irgendwann dadurch erreicht, dass mehr minderwertiger Content entsteht statt besser zielgerichteter.
Das ist kein hypothetisches Risiko, sondern nahezu unausweichlich, sobald eine einzelne Kennzahl zum wichtigsten Maßstab einer Rolle wird. Wer vor allem daran gemessen wird, wie viele Stücke pro Woche freigegeben werden, findet verständlicherweise und ohne böse Absicht Wege, schneller freizugeben, und der einfachste Weg ist fast immer, weniger genau hinzusehen. Jede Geschwindigkeitskennzahl mit einer ebenso sichtbaren Qualitäts- oder Wertkennzahl zu paaren und klarzumachen, dass beide gemeinsam bewertet werden und nicht eine als Nebensache, verhindert diese Dynamik.
Dieselbe Dynamik gilt fürs Entwerfen, nicht nur fürs Review. Wer vor allem an der Zahl der Entwürfe pro Woche gemessen wird, ohne dass eine qualitätsbereinigte Gegenkennzahl daneben sichtbar ist, wird rationalerweise zu den Inhalten tendieren, die sich am schnellsten entwerfen lassen, und nicht zu denen, die den größten Wert haben, selbst wenn niemand das beabsichtigt. Das ist eine strukturelle Folge davon, wie die Kennzahl gebaut ist, und kein Urteil über Professionalität oder Einsatz. Es wiederholt sich zuverlässig über Teams und Organisationen hinweg, weil es aus der Anreizstruktur folgt und nicht aus Charakterfragen. Die Lösung ist dieselbe wie auf der Review-Stufe: Eine Geschwindigkeitskennzahl darf nie allein stehen, wenn eine Rolle daran gemessen wird.
| Kennzahl | Formel | Datenquelle | Verantwortung | Leitplanke | Entscheidung, die sie stützt |
|---|---|---|---|---|---|
| Durchlaufzeit | Veröffentlichungsdatum minus Eingangsdatum | Zeitstempel im Content-Management-System | Leitung Content Operations | Darf nicht dadurch sinken, dass die Review-Tiefe unter die Anforderung der Risikostufe fällt | Ob die aktuellen Lieferzeiten die Geschäftszusagen erfüllen |
| Wartezeit | Wartezeit minus aktive Bearbeitungszeit | Zeitstempel je Stufe | Leitung Content Operations | Getrennt von der Bearbeitungszeit erfassen, damit Wartezeitprobleme nicht verdeckt werden | Wo in Kapazität oder Prozessumbau investiert wird |
| First-Pass-Yield | Ohne substanzielle Überarbeitung freigegebener Content geteilt durch alle geprüften Inhalte | Aufzeichnungen im Review Evidence Pack | Governance-Verantwortliche | Nur zusammen mit dem Schweregrad der Fehler lesen, nie als alleinige Erfolgskennzahl | Ob die Qualität von Briefing und Entwurf in den vorgelagerten Stufen steigt |
| Nacharbeitsquote | Zur Überarbeitung zurückgegebener Content geteilt durch alle geprüften Inhalte | Aufzeichnungen im Review Evidence Pack | Leitung Content Operations | Muss die Ursache unterscheiden (Recherchelücke, Entwurfsfehler, Änderung des Umfangs) | Welche vorgelagerte Stufe Prozessverbesserung braucht |
| Kosten pro freigegebenem Asset | Gesamte zugeordnete Kosten geteilt durch freigegebene, veröffentlichte Assets | Unterlagen aus Finanzwesen und Betrieb | Finanzpartner gemeinsam mit der Leitung Content Operations | Muss Review-, Fachexperten- und Pflegekosten enthalten, nicht nur Entwurfskosten | Kapazitäts- und Tooling-Entscheidungen |
| Qualitätsbereinigter Durchsatz | Freigegebenes Volumen, gewichtet nach Fehlerfreiheit und geschäftlicher Relevanz | Kombinierte Review- und Performance-Daten | Leitung Content Operations | Nie allein als Rohvolumen berichten | Ob echte Kapazitätsgewinne erzielt werden |
 KI-generiert Bild
Den Engpass finden
Sobald der Fluss abgebildet und gemessen ist, zeigt sich der tatsächliche Engpass, die einzelne Stufe, die den Gesamtdurchsatz des Systems am stärksten begrenzt, meist dort, wo sich Work in Progress staut und die Blockadezeit konzentriert. In den meisten KI-gestützten Content-Betrieben, die wir beobachten, ist dieser Engpass vom Entwerfen, das vor der KI-Unterstützung die langsamste Stufe war, zu Recherche, fachlichem Review oder zu Fachleuten gewandert, deren Verfügbarkeit nicht so skaliert wie die Entwurfskapazität.
| Beobachtbares Symptom | Wahrscheinlicher Engpass | Empfohlene Maßnahme |
|---|---|---|
| Entwürfe stauen sich vor dem Review | Review-Kapazität | Weitere qualifizierte Review-Kräfte schulen; risikobasierte Review-Tiefe konsequent anwenden |
| Recherche dauert länger als das Entwerfen | Recherche-Workflow oder Quellenzugang | Disziplin strukturierter AI Research Workflows anwenden; Quellenhierarchie und Tooling verbessern |
| Bestimmte Content-Kategorien stocken immer wieder | Knappe Verfügbarkeit von Fachleuten | Expert Knowledge Capture einsetzen, um den wiederholten Zeitbedarf der Fachleute zu senken |
| Hohe Nacharbeit nach dem Review | Unklares Briefing oder unklare Abnahmekriterien | Den Vertrag der Stufe Research & Briefing schärfen; Kriterien je Risikostufe klären |
| Freigegebener Content wartet auf die Veröffentlichung | Kapazität im Publishing oder unklare Freigabebefugnis | Entscheidungsrechte klären; Übergabe zur Veröffentlichung verschlanken |
Verbesserungsaufwand, der irgendwo anders als am tatsächlichen Engpass ansetzt, bringt auf Systemebene meist wenig sichtbaren Nutzen, auch wenn er die adressierte Stufe tatsächlich verbessert. Denn der Durchsatz der gesamten Pipeline wird von ihrem engsten Engpass bestimmt und nicht von der durchschnittlichen Kapazität über alle Stufen.
Das hat eine konkrete, kontraintuitive Konsequenz, die man klar aussprechen sollte: Weiter in schnelleres Entwerfen zu investieren, obwohl das Entwerfen nicht mehr der Engpass ist, bringt auf Systemebene nahezu keinen Nutzen, so beeindruckend die Verbesserung auf der Entwurfsstufe für sich genommen aussieht. Eine Organisation, die weiter in Entwurfsgeschwindigkeit investiert, nachdem der Engpass zu Review oder Recherche gewandert ist, optimiert eine Stufe, die im Verhältnis zu dem, was der Rest des Systems aufnehmen kann, ohnehin Luft hat. Das ist ein naheliegender, aber unproduktiver Reflex, sobald ein Tool (auf Englisch) überzeugend gezeigt hat, dass es schneller entwerfen kann. Die Disziplin besteht darin, den tatsächlichen Engpass laufend neu zu bestimmen, statt anzunehmen, er bleibe bei der Stufe, die historisch die langsamste war.
Mit KI und Automatisierung verbessern
KI und Automatisierung gehören auf klar abgegrenzte Aufgaben, bei denen die Organisation die Ausgabequalität verlässlich prüfen kann, und nicht breit auf jede Aufgabe, die eine Stufe zufällig enthält. Entwurfsunterstützung, Recherche-Triage und strukturierte Extraktionsaufgaben, ausführlich behandelt in AI Research Workflows und im AI Editorial Operating System, sind in der Regel gute Kandidaten. Aufgaben, die Urteilskraft unter Mehrdeutigkeit erfordern, etwa das Abwägen widersprüchlicher Belege oder die finale Einstufung der Risikostufe, eignen sich schlecht für unbeaufsichtigte Automatisierung, egal wie viel Zeit sie scheinbar verschlingen.
Jede Automatisierungsentscheidung sollte das Qualitätsrisiko ausdrücklich gegen die gesparte Zeit abwägen und Geschwindigkeit nicht als einzige relevante Variable behandeln. Eine Automatisierung, die bei einer risikoarmen Aufgabe spürbar Zeit spart, ist ein klarer Gewinn. Dieselbe Automatisierung bei einer Aufgabe mit hohem Risiko, bei der ein Fehler unverhältnismäßig teuer ist, lohnt sich unter Umständen nicht, selbst wenn sie meistens korrekt funktioniert, weil die Kosten der Fälle, in denen sie nicht korrekt funktioniert, die gesamte Zeitersparnis aufwiegen können.
Außerdem lohnt die Unterscheidung zwischen Automatisierung, die eine Aufgabe ganz entfallen lässt, und Automatisierung, die nur ändert, wer sie erledigt, ohne den Gesamtaufwand zu senken. Eine automatisch erzeugte, strukturierte Erstgliederung aus einem freigegebenen Briefing nimmt echte Arbeit ab, die zuvor ein Mensch von Hand erledigt hat. Ein automatisch erzeugter Entwurf, der dieselbe Tiefe an Faktenprüfung und Überarbeitung verlangt wie ein menschlicher Entwurf, hat den Aufwand faktisch nur verlagert und nicht verringert. Ein Messsystem, das nur die Entwurfszeit erfasst, überschätzt in genau dieser Situation den Effizienzgewinn. Die qualitätsbereinigte Durchsatzkennzahl in der Tabelle oben dient genau dazu, solche scheinbaren Gewinne aufzufangen, die einer Gesamtrechnung über das ganze System nicht standhalten.
Experimentieren und standardisieren
Prozessänderungen sollten als bewusste Experimente getestet werden und nicht allein aufgrund eines plausiblen Arguments flächendeckend eingeführt werden. Ein ordentliches Experiment definiert eine Baseline (aktuelle Leistung bei den relevanten Kennzahlen), eine konkrete Hypothese (was wird getestet und warum sollte es helfen), die Leitplanken, die durchgehend halten müssen (die Qualitäts- und Wertkennzahlen, die nicht schlechter werden dürfen), einen festgelegten Testzeitraum und eine Entscheidungsregel für das Ergebnis: Änderung standardisieren, überarbeiten oder verwerfen.
Eine Änderung, die ihr Experiment bestanden hat, zu standardisieren heißt, sie so klar zu dokumentieren, dass sie zur neuen Standardpraxis wird und nicht stillschweigend zurückfällt, sobald die Person, die sie vorangetrieben hat, zu einem anderen Projekt wechselt. Standardisierung ohne Dokumentation ist der häufigste Grund, warum eine wirklich gute Prozessverbesserung ihren ersten Pilot nicht überdauert.
Leitplanken müssen während des gesamten Experiments geprüft werden und nicht erst an dessen Ende. Eine Änderung, die mitten im Testzeitraum bei ihrer Hauptkennzahl gut aussieht, kann gleichzeitig eine Leitplankenkennzahl untergraben, die niemand aktiv beobachtet, bis der Testzeitraum endet und das ganze Bild sichtbar wird. Bis dahin ist die Änderung womöglich schon informell anderswo übernommen worden. Wer die Leitplanken in regelmäßigen Abständen prüft, nicht nur als abschließendes Bestanden/Nicht-bestanden-Tor, erkennt solche Abweichungen, solange sich das Experiment noch anpassen lässt, und entdeckt das Problem nicht erst im Nachhinein.
Wirtschaftlichkeit und Kapazitätsentscheidungen
Kapazitäts- und Tooling-Entscheidungen sollten auf Vollkosten beruhen und nicht nur auf den sichtbaren Kosten einer Softwarelizenz oder eines Abonnements für ein Entwurfs-Tool. Review-Zeit, Fachexpertenzeit, Nacharbeitskosten und laufende Pflegekosten gehören alle in die Rechnung. Wer sie weglässt, überschätzt systematisch, wie viel eine Investition der Organisation tatsächlich spart.
Bei Personalentscheidungen ist besondere Vorsicht geboten, wenn sie sich vor allem auf die Demo eines Tool-Anbieters oder einen Pilot unter ungewöhnlich günstigen Bedingungen stützen. Ein Entwurfs-Tool, das bei einer sauberen, klar umrissenen Pilotaufgabe beeindruckt, kann sich deutlich anders verhalten, wenn es die gesamte Bandbreite des Contents der Organisation verarbeitet, einschließlich der unordentlicheren, mehrdeutigeren Anfragen, die eine Demo nie abdeckt. Eine Kapazitätsentscheidung, die vor diesem Realitätscheck fällt, kann die Organisation ausgerechnet dort unterbesetzt lassen, wo sie Kapazität am dringendsten braucht.
Kapazitätsentscheidungen sollten auch den Pflegeaufwand berücksichtigen, den eine wachsende Content-Bibliothek mit der Zeit erzeugt, und nicht nur die Kosten neuer Inhalte. Jedes veröffentlichte Asset, das die Organisation korrekt und aktuell halten will, erhöht den laufenden Pflegeaufwand in kleinem, aber realem Maß: Aussagen prüfen, wenn sich Quellen ändern, bestätigen, dass die Bezüge zum Framework mit dem Glossar übereinstimmen, kontrollieren, dass Links noch funktionieren. Eine Effizienzanalyse, die nur die Produktionskosten zählt und diesen wachsenden Pflegeschwanz ignoriert, unterschätzt die wahren Kosten der Content Operations systematisch, je größer die veröffentlichte Bibliothek wird. Eine Content-Erweiterung, die beim Start klar gerechtfertigt wirkte, sieht dann deutlich weniger vorteilhaft aus, wenn sich einige Jahre Pflegeverpflichtung dahinter angesammelt haben.
Fehlerbilder bei der Content-Produktionseffizienz
Lokale Optimierung, also die Kennzahlen einer Stufe zu verbessern, ohne den Gesamtdurchsatz des Systems zu beachten, ist der häufigste Fehler. Sie verführt gerade deshalb, weil die lokale Verbesserung real und messbar ist, auch wenn ihre Wirkung auf Systemebene gering oder sogar negativ ist. Vanity Output, also gesteigertes Rohvolumen zu feiern, ohne den qualitätsbereinigten Durchsatz zu prüfen, folgt dicht dahinter. Ein dritter Fehler ist, beim Entwerfen eingesparte Zeit automatisch als realisierten Geschäftswert zu verbuchen, obwohl diese Zeit in der Praxis häufig einfach in mehr Content derselben Art aufgeht, statt in höherwertige Arbeit umgelenkt zu werden.
Ein vierter Fehler, den man leicht übersieht, bis er schon zum Problem geworden ist: Auslastung zu messen statt Fluss. Wer im Review oder beim Schreiben voll ausgelastet wirkt, restlos verplant, jede Stunde verbucht, trägt nicht zwangsläufig zu schnellerer Gesamtlieferung bei. Ein voll ausgelastetes System hat keinen Puffer für Schwankungen. Das erhöht paradoxerweise tendenziell Wartezeit und Durchlaufzeit, statt sie zu senken, weil jede unerwartete Komplexität und jede dringende Anfrage nirgendwohin kann, ohne etwas anderes Laufendes zu verdrängen. Ein System mit bewusst eingeplanter Reservekapazität liefert statt auf maximale Auslastung getrimmt oft verlässlicher und mit kürzeren durchschnittlichen Wartezeiten. Dieses kontraintuitive Ergebnis wird erst klar, wenn die Wartezeit tatsächlich gemessen wird und nicht einfach als direkt mit der Auslastung verbunden angenommen wird.
Häufig gestellte Fragen
Verbessert schnelleres Entwerfen immer Ihre Gesamteffizienz?
Nein. Wenn Review-, Fachexperten- oder Freigabekapazität nicht ebenfalls wächst, verschiebt schnelleres Entwerfen den Engpass lediglich nach hinten und erzeugt oft einen größeren Rückstau an der Stufe, die zum neuen Engpass wird.
Was unterscheidet diesen Leitfaden von Content Supply Chain?
Dieser Leitfaden konzentriert sich darauf, Fluss und Qualität innerhalb des Produktionssystems zu messen und zu verbessern. Content Supply Chain behandelt das breitere Design von Kapazität, Abhängigkeiten und Resilienz über den gesamten Betrieb, einschließlich Partnersteuerung und Single-Point-of-Failure-Risiko. Beide ergänzen sich: Eine Supply Chain kann gut gestaltet sein und trotzdem ineffizient laufen, wenn niemand sie misst, und Kennzahlen allein beheben keine strukturell unterbesetzte Pipeline.
Woran erkennen Sie, ob eine Effizienzkennzahl eine Leitplanke braucht?
Wenn die isolierte Optimierung dieser Kennzahl plausibel Qualität, Risikomanagement oder Geschäftswert beeinträchtigen könnte, braucht sie eine ausdrückliche Leitplanke. In der Praxis erfüllt nahezu jede Flusskennzahl dieses Kriterium. Deshalb enthält jede Kennzahl in der Tabelle dieses Leitfadens eine.
Ist es je vertretbar, auf Basis KI-gestützter Effizienzgewinne Personal abzubauen?
Das ist eine unternehmerische Entscheidung außerhalb des Rahmens dieses Leitfadens, sie sollte aber nie allein aus Zeitersparnissen beim Entwerfen getroffen werden. Sie braucht eine Gesamtsicht des Systems darauf, wo die Kapazität tatsächlich begrenzt ist, denn der Engpass ist typischerweise zu Recherche oder Review gewandert und nicht aus dem Kapazitätsbedarf der Organisation insgesamt verschwunden.
Wie oft sollten Sie Ihre Workflow-Abbildung und Kennzahlen überprüfen?
Immer dann, wenn ein wesentlicher Prozess- oder Tooling-Wechsel eingeführt wird, und als feste Praxis mindestens vierteljährlich, denn Engpässe verschieben sich mit der Zeit, wenn sich KI-Fähigkeiten, Teamzusammensetzung und Content-Volumen ändern.
Was ist ein sinnvoller erster Schritt, wenn Ihre Organisation noch nichts davon misst?
Beginnen Sie klein, statt die gesamte Pipeline auf einmal auszustatten. Wählen Sie Durchlaufzeit und First-Pass-Yield, die beiden Kennzahlen, die am direktesten zeigen, ob die Arbeit gut fließt und ob die Qualität in den vorgelagerten Stufen hält. Wenden Sie sie auf eine einzelne Content-Kategorie über einen vollständigen Messzeitraum an und erweitern Sie Kennzahlen und Umfang erst, wenn diese erste enge Messung etabliert ist und ihr vertraut wird. Ein umfassender Messrollout über alle Kennzahlen und alle Content-Kategorien gleichzeitig erzeugt tendenziell einen so großen Berichtsaufwand, dass er unter der eigenen Last zusammenbricht, bevor er brauchbare Erkenntnisse liefert.
Das System messen, nicht die Stufe
Effizienzverbesserung, die Qualität respektiert, braucht die Messung des gesamten Flusses und nicht nur der Teile, die sich am leichtesten beschleunigen lassen. Content Supply Chain weitet diese Sicht auf Kapazität und Resilienz in größerem Maßstab aus. Human Review for AI Content beschreibt die Mechanik der Review-Stufe, auf die die Engpassanalyse dieses Leitfadens häufig zurückführt. Organisationen, die ihren eigenen Fluss messen wollen, können mit einem kōdōkalabs Executive AI Marketing Assessment starten.