Definition, Umfang und eine ehrliche Unsicherheit
LLM-Optimierung ist nach der engen Definition dieses Leitfadens die Praxis, Zugänglichkeit, Klarheit, Herkunft und Extrahierbarkeit maßgeblicher Inhalte für Systeme zu verbessern, die Informationen mithilfe großer Sprachmodelle abrufen, interpretieren und zusammenführen. Sie ist eine Komponente der übergeordneten Disziplin Generative Engine Optimization, die im Leitfaden zu Generative Engine Optimization vollständig behandelt wird. Sie ist keine eigene Kategorie und keine garantierte Methode, um zu beeinflussen, was ein bestimmtes Modell auf eine bestimmte Anfrage generiert.
Die ehrliche Unsicherheit im Kern dieses Themas: Kein großer LLM-Anbieter hat eine vollständige Darstellung veröffentlicht, wie in seinen Systemen Entscheidungen über Retrieval, Ranking und Zitate getroffen werden. Dokumentiert und Grundlage dieses Leitfadens sind konkrete, offengelegte Mechaniken wie Crawler-Verhalten, Indexierungsberechtigung und Referral-Tagging, auf die Unternehmen sich verlassen können. Sie sind klar getrennt von begründeter Schlussfolgerung aus der Praxis darüber, was wahrscheinlich hilft. Diese kennzeichnet der Leitfaden als solche, statt sie als bestätigte Tatsache auszugeben.
Der Leitfaden behandelt semantisches HTML, zugängliches Rendering, Steuerung von Crawling und Indexierung, Klarheit auf Ebene einzelner Textpassagen, direkte Definitionen, beschreibende Überschriften, Tabellen, Quellenangaben, Aktualität, Kanonisierung, strukturierte Daten, Eigenständigkeit von Passagen, Entitätskonsistenz und Tests. Crawler-Zugang und neu entstehende Konventionen bespricht er nur mit aktueller, datierter Beleglage und ausdrücklich benannten Einschränkungen. Er behandelt kein Prompt Engineering, ist keine vollständige Umsetzungsanleitung für AI Overviews (dafür gibt es den Leitfaden AI Overviews Strategy) und keine vollständige Wiedergabe der GEO-Kategorie (dafür gibt es den Leitfaden Generative Engine Optimization).
Wie sich LLM-gestütztes Retrieval unterscheidet
Klassische Suchindexierung und LLM-gestütztes Retrieval haben eine gemeinsame Grundlage, denn beide verlangen crawlbare Inhalte. Sie gehen aber auseinander, sobald ein System Zugriff auf eine Seite hat. Ein klassischer Suchindex muss vor allem eine Anfrage einer Rangliste von Dokumenten zuordnen. Ein System mit Retrieval-Augmented Generation, bei dem ein Live- oder aktueller Abrufschritt Quellenmaterial liefert, das ein Sprachmodell zu einer Antwort zusammenführt, braucht Inhalte, die auf Ebene einzelner Passagen klar genug sind, damit ein Modell bestimmte Fakten korrekt extrahieren und wiedergeben kann, oft ohne den vollen Kontext, den ein menschlicher Leser hätte.
Daraus ergibt sich eine praktische Folge, die sich von der klassischen SEO unterscheidet: Passagen müssen einigermaßen in sich geschlossen und auch isoliert gelesen korrekt sein, nicht nur als Teil einer ganzen Seite. Ein Satz, der erst vor dem Hintergrund einer Aussage von vor drei Absätzen Sinn ergibt, ist für Lesende, die eine Seite der Reihe nach durcharbeiten, eine normale und oft wirksame Schreibtechnik. Für ein System, das diesen Satz als isolierte Passage ohne den vorangehenden Kontext abruft, ist er eine Schwachstelle. Das heißt nicht, in kurzen, zusammenhanglosen Fragmenten zu schreiben, wovor sowohl OpenAI als auch Google in ihren eigenen Empfehlungen als unwirksamer und leserfeindlicher Taktik warnen. Es heißt, so zu schreiben, dass Kernfakten klar benannt sind und nicht allein von weit entferntem Kontext abhängen, um richtig verstanden zu werden.
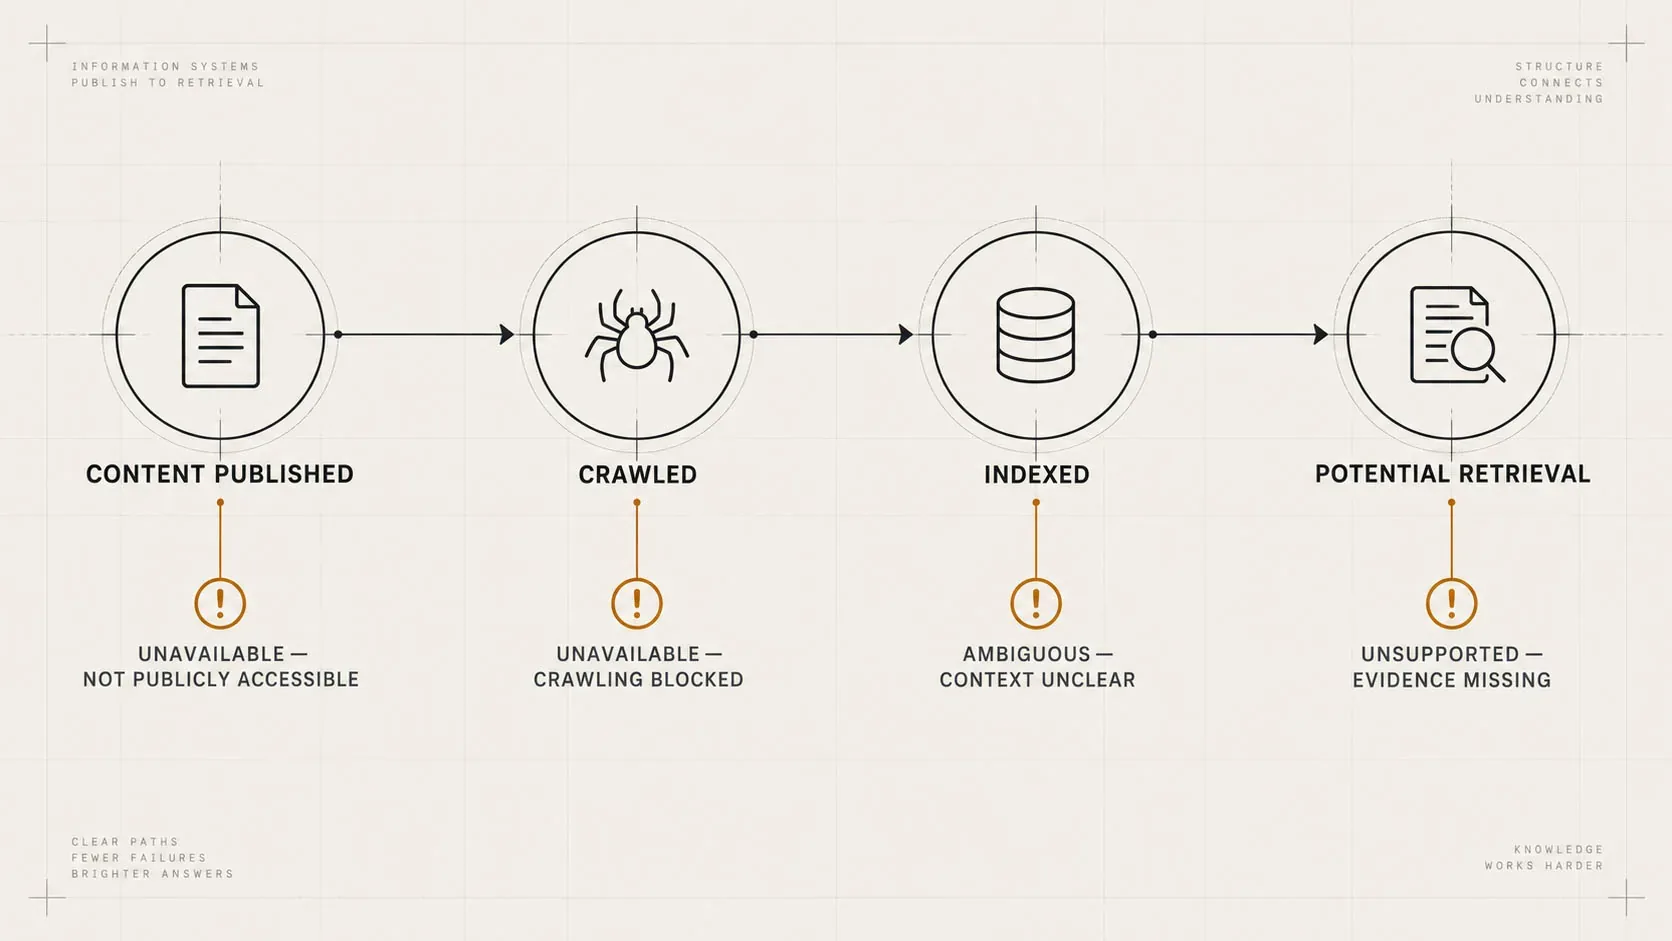
Wichtig ist auch, mehrere unterschiedliche Konzepte der LLM-Optimierung auseinanderzuhalten, die in weniger sorgfältigen GEO-Beiträgen häufig und fälschlich vermischt werden: Trainingszugang (ob ein Modell mit Inhalten trainiert wurde, eine Entscheidung aus der Vergangenheit, die sich im Nachhinein nicht umkehren lässt), Crawling (ob ein bestimmter, aktueller Crawler derzeit auf eine Seite zugreifen kann), Indexierung (ob eine Plattform diesen Inhalt für den Abruf verarbeitet und gespeichert hat), Live-Retrieval (ob ein System zum Zeitpunkt einer Anfrage aktuelle Inhalte abruft oder heranzieht), Grounding (ob eine generierte Antwort auf abgerufenem Quellenmaterial beruht und nicht allein auf den trainierten Parametern des Modells) und Zitat (ob eine Quelle in einer generierten Antwort ausdrücklich genannt wird). Eine Seite kann gecrawlt und indexiert werden, ohne je für eine bestimmte Anfrage abgerufen zu werden, und kann abgerufen und für Grounding genutzt werden, ohne je ausdrücklich zitiert zu werden. Jeder dieser Schritte ist eigenständig steuerbar oder beobachtbar.
Anforderungen auf der Inhaltsebene
Auf der Inhaltsebene unterstützen mehrere Praktiken durchgängig sowohl das Verständnis für Menschen als auch die Extrahierbarkeit für Maschinen. Sie beruhen auf offiziellen Plattformempfehlungen oder etablierter Praxis der Web-Barrierefreiheit, nicht auf spekulativen KI-spezifischen Taktiken. Nennen Sie klare Definitionen früh in einem Abschnitt, statt sich über mehrere Absätze Anlauf zu einer Definition aufzubauen. Verwenden Sie beschreibende, konkrete Überschriften, die sagen, was ein Abschnitt behandelt, statt witziger oder mehrdeutiger Formulierungen, bei denen man den Abschnitt lesen muss, um sein Thema zu verstehen. Stellen Sie vergleichende oder strukturierte Informationen in zugänglichen Tabellen statt in dichten Fließtextabsätzen dar, denn Tabellen sind für Menschen leichter zu überfliegen und für Maschinen verlässlicher auslesbar. Nennen Sie Quellen und Daten ausdrücklich, also woher ein Fakt oder eine Zahl stammt, statt sie als nicht belegte Behauptung zu präsentieren. Halten Sie die Entitäten konsistent und verwenden Sie dieselben kanonischen Namen für Personen, Marken und Konzepte, die Sie in Entity SEO festgelegt haben, damit ein System, das eine Passage isoliert extrahiert, trotzdem richtig erkennt, worauf sie sich bezieht.
Anforderungen auf der Auslieferungsebene
Auf der Auslieferungsebene entscheidet die technische Umsetzung, ob gut geschriebene Inhalte überhaupt erreichbar sind und korrekt ausgelesen werden. Stellen Sie sicher, dass Inhalte in einer Form gerendert werden, die für die konkreten, dokumentierten Crawler der Plattformen zugänglich ist, die das Unternehmen zulassen will, gemäß der Zugriffsrichtlinie aus AI Crawler Accessibility und Technical GEO. Serverseitig oder vorab gerenderte Inhalte sind für automatisierte Abrufe in der Regel verlässlicher zugänglich als Inhalte, die vollständig davon abhängen, dass clientseitige JavaScript-Ausführung für jeden Crawler einwandfrei funktioniert. Sorgen Sie für klare, korrekte Kanonisierung, damit doppelte oder nahezu doppelte Seitenversionen keine Unklarheit schaffen, welche die maßgebliche ist. Setzen Sie strukturierte Daten ein, die den sichtbaren Inhalt zutreffend beschreiben und das Parsing und Verständnis von Seitenstruktur und Entitäten durch die Plattform unterstützen, im Einklang mit dem gemeinsamen Metadaten- und Schema-Standard dieser Säule. Halten Sie Inhalte aktuell, wo Aktualität für das Thema wirklich relevant ist, und machen Sie die tatsächlichen Veröffentlichungs- und Änderungsdaten korrekt und sichtbar, denn veraltete Inhalte, die als aktuell auftreten, sind ein Vertrauensrisiko und nach Googles eigener Empfehlung kein Ersatz für wirklich nützliche Inhalte.
Das LLM Content Accessibility Audit
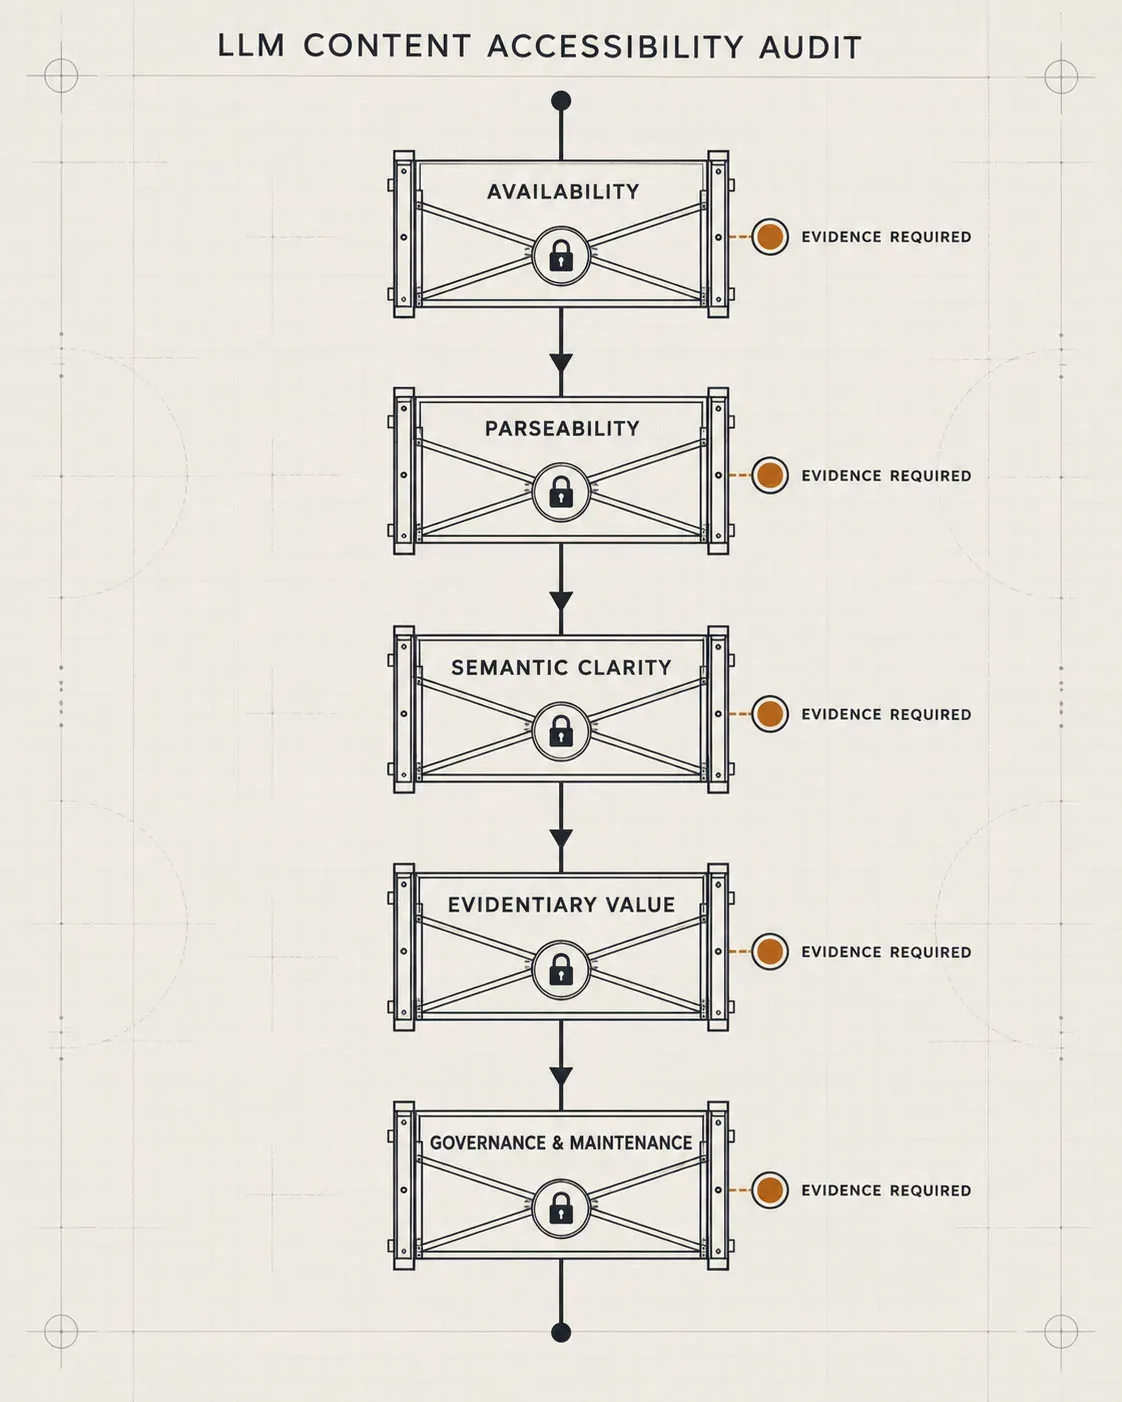
kōdōkalabs nutzt ein Audit aus fünf Ebenen, unsere eigene diagnostische Rahmung für den Umfang dieses Leitfadens, um zu beurteilen, ob ein Inhalt für LLM-gestütztes Retrieval und Synthese wirklich zugänglich ist. Dieses Audit ist eine Synthese von kōdōkalabs, die die oben beschriebenen praktischen Anforderungen ordnet. Es wird hier nicht als offiziell abgestimmter Bestandteil eines größeren, benannten Dachs-Frameworks dargestellt, da für diese breitere Struktur in der Wissensbasis von kōdōkalabs derzeit keine solche kanonische Aufzeichnung besteht.
| Ebene | Was sie prüft | Nachweis zum Bestehen |
|---|---|---|
| Verfügbarkeit | Können die relevanten, dokumentierten Crawler den Inhalt überhaupt erreichen und abrufen? | Ein dokumentierter, aktueller Crawler-Zugangstest gegen die Plattformen, die das Unternehmen zulassen will |
| Auslesbarkeit | Wird der Inhalt in einer Form gerendert, die sich verlässlich auslesen lässt, unabhängig davon, ob clientseitiges JavaScript erfolgreich läuft? | Ein Rendering-Test, der vergleicht, was ein Abruf wie von einem Crawler erhält, mit der vollständig gerenderten Seite |
| Semantische Klarheit | Sind Kernfakten direkt benannt, mit beschreibenden Überschriften und in sich geschlossenen Passagen? | Eine redaktionelle Prüfung anhand der Anforderungen der Inhaltsebene oben |
| Belegwert | Bringt der Inhalt echten Informationsgewinn und belegte Quellen mit, gemäß den Standards in Information Gain? | Ein Abgleich mit dem Information Gain Ledger für den betreffenden Inhalt |
| Governance und Pflege | Werden Aktualität, Kanonisierung und strukturierte Daten des Inhalts über die Zeit aktuell und korrekt gehalten? | Ein fester Prüfrhythmus mit dokumentiertem Datum der letzten Prüfung |
Ein Inhalt, der Verfügbarkeit und Auslesbarkeit besteht, aber bei semantischer Klarheit und Belegwert durchfällt, ist technisch erreichbar, aber als Quelle für die Synthese weiterhin wenig nützlich. Alle fünf Ebenen zählen zusammen, keine allein für sich.
 KI-generiert Bild
 KI-generiert Bild
Experimentelle Validierung
Jede Empfehlung in diesem Leitfaden sollte mit einer Möglichkeit verbunden sein zu prüfen, ob sie tatsächlich wirkt, statt sie rein auf Glauben zu übernehmen. Praktische Validierungsmethoden sind: den Abruf einer Seite wie von einem Crawler (was ein automatisiertes System tatsächlich erhält) mit der vollständig gerenderten Seite zu vergleichen, die Menschen sehen, um Lücken bei der Auslesbarkeit zu finden; zu prüfen, ob die eigene Berichterstattung einer Plattform, wo vorhanden, etwa die AI-Performance-Ansicht von Bing, die Seite in Stichproben von Grounding-Anfragen zeigt; und regelmäßig eine definierte Menge relevanter Anfragen in verfügbaren KI-Produkten stichprobenartig zu testen, um qualitativ zu beobachten, ob und wie Inhalte dargestellt werden, im Bewusstsein, dass dies eine Stichprobe ist und kein Nachweis eines bestimmten ursächlichen Mechanismus. Den Leitfaden Measuring AI Search Visibility and Citation Tracking behandelt diese Stichproben-Methodik im Detail.
Mythen, Risiken und Grenzen
Mehrere hartnäckige Behauptungen zur LLM-Optimierung sind durch die aktuelle Plattformdokumentation nicht gedeckt und sollten Sie mit Skepsis behandeln. Es gibt keine besondere Datei, vergleichbar einer Sitemap, die Aufnahme oder Zitat in ein LLM garantiert. Google hat ausdrücklich erklärt, dass es für seine eigenen KI-Funktionen keine solche Anforderung gibt. Es gibt keine bestätigte, universell „optimale Chunk-Größe“ für Inhaltspassagen, die über alle Plattformen hinweg besseres Retrieval garantiert. Das ist ein sinnvolles Feld, in dem Unternehmen an eigenen Inhalten testen können, aber keine dokumentierte Plattformanforderung. Es gibt keinen Hinweis darauf, dass unsichtbares oder verstecktes Markup, das nur für die Maschine gedacht ist und keine tatsächlich sichtbaren Inhalte beschreibt, die Zitierwahrscheinlichkeit erhöht. Die Empfehlungen aller großen Suchmaschinen zu strukturierten Daten sind eindeutig: Markup soll sichtbare Inhalte beschreiben und keine versteckten Aussagen ergänzen.
Die ehrliche Einschränkung, die allen Empfehlungen dieses Leitfadens zugrunde liegt: Das Verhalten von Plattformen ändert sich, mitunter ohne Vorankündigung, und jede konkrete technische Aussage in diesem Leitfaden hat ein Verfallsdatum. Sie sollte vor einer weiteren Verwendung als noch zutreffend gegen die aktuelle Erstanbieter-Dokumentation geprüft werden, besonders bei zeitkritischen Aussagen über das aktuelle Verhalten einer benannten Plattform.
Häufig gestellte Fragen
Ist LLM-Optimierung dasselbe wie GEO?
Nein. LLM-Optimierung ist eine Komponente der übergeordneten Disziplin Generative Engine Optimization, mit Fokus auf Zugänglichkeit von Inhalt und Auslieferung für LLM-basiertes Retrieval und Synthese. Die gesamte Kategorie beschreibt der Leitfaden Generative Engine Optimization.
Muss Ihr Inhalt in ein Modell trainiert worden sein, um in dessen Antworten zu erscheinen?
Nein, das sind getrennte Mechanismen. Trainingszugang ist eine Entscheidung, die der Modellentwickler in der Vergangenheit getroffen hat und die ein Unternehmen nicht nachträglich beeinflussen kann. Live-Retrieval und Grounding, die viele aktuelle KI-Produkte nutzen, können aktuelle Inhalte unabhängig davon zeigen, ob sie Teil der Trainingsdaten eines Modells waren, vorausgesetzt, der Inhalt ist jetzt crawlbar und zugänglich.
Gibt es eine ideale Inhaltslänge oder Chunk-Größe für LLM-Retrieval?
Eine bestätigte, plattformübergreifend gültige Zahl gibt es nicht. Konzentrieren Sie sich auf Klarheit und in sich geschlossene Passagen statt auf eine bestimmte Wort- oder Zeichenzahl, und behandeln Sie jedes konkrete Zahlenziel als ungetestete Hypothese, die Sie an Ihren eigenen Inhalten prüfen, nicht als dokumentierte Anforderung.
Sollten Sie KI-Crawler blockieren, damit Ihre Inhalte nicht zum Training von Modellen für Mitbewerber verwendet werden?
Das ist eine legitime, bewusste Richtlinienentscheidung mit echten Zielkonflikten, ausführlich behandelt in AI Crawler Accessibility and Technical GEO. Dieser Leitfaden trifft diese Entscheidung nicht für Sie, denn sie hängt von der konkreten Wettbewerbs- und Risikolage des Unternehmens ab.
Wie oft sollten Sie Ihre LLM-Zugänglichkeit neu prüfen?
In einem festen Rhythmus, gekoppelt an die Ebene Governance und Pflege des Audits oben, und sofort, wenn eine Plattform eine dokumentierte Änderung an Crawling, Indexierung oder Retrieval ankündigt, die für Ihre Inhalte relevant ist.
Wo sollten Sie anfangen?
Mit den Ebenen Verfügbarkeit und Auslesbarkeit des Audits: Stellen Sie sicher, dass die Plattformen, die Sie zulassen wollen, Ihre priorisierten Inhalte tatsächlich erreichen und korrekt rendern können, bevor Sie weiter in die Verfeinerung der Inhaltsebene investieren.
Passende Lösungspfade
Bewerten Sie die Inhalts-, Wissens- und Technikebenen, die darüber entscheiden, ob Ihr Fachwissen für KI-Systeme nutzbar ist, im Rahmen eines vollständigen AI Marketing Operating System.