Was strukturierte Daten leisten können und was nicht
Strukturierte Daten, meist als JSON-LD umgesetzt, geben einer Webseite die Möglichkeit, maschinenlesbar und ausdrücklich zu benennen, wovon ihr sichtbarer Inhalt handelt: welche Entitäten sie beschreibt, wie diese zusammenhängen und welche Art von Inhalt die Seite darstellt. Mehr leisten sie nicht. Sie können weder eine Ranking-Verbesserung noch ein Rich Result in der Suche noch die Aufnahme in eine KI-generierte Antwort oder eine Zitierung garantieren. Googles aktuelle Richtlinien sind an dieser Stelle eindeutig: Für die generativen KI-Funktionen der Suche gibt es keine besondere Schema-Anforderung, und die Eignung für eine bestimmte Funktion garantiert nie, dass diese Funktion tatsächlich angezeigt wird (Google Search Central, Einführung in strukturierte Daten und allgemeine Richtlinien (öffnet in einem neuen Tab), geprüft am 14.09.2026).
Dieser Leitfaden behandelt strukturierte Daten als eine gesteuerte semantische Ebene innerhalb der übergeordneten Fähigkeit Search Intelligence. Sie ist wertvoll für interne Konsistenz und für die Eignung für bestimmte, unterstützte Funktionen der Suchplattformen, aber nie eine Abkürzung an Inhaltsqualität, Entitätsklarheit, technischem Zugang und Beleg-Disziplin vorbei, die an anderer Stelle in diesem Pillar behandelt werden. Eine Seite mit exzellenten, validen strukturierten Daten und schwachem, abgeleitetem Inhalt ist in keinem sinnvollen Sinn sichtbarer als derselbe schwache Inhalt ohne Markup. Das Markup beschreibt, was bereits da ist, und gleicht nicht aus, was fehlt.
Der Leitfaden behandelt das Schema.org-Vokabular, JSON-LD als bevorzugtes Format, das Konzept des verbundenen Knotengraphen, stabile @id-Werte, die für diesen Pillar relevanten Kerntypen (Organization, Person, WebSite, Article, BreadcrumbList und weitere, je nach Kontext passende Typen), die Eigenschaften sameAs, mainEntity, about und mentions, die Übereinstimmung mit dem sichtbaren Inhalt, plattformspezifische Anforderungen, die Umsetzung über WordPress-Templates, Validierung, Monitoring, Zuständigkeiten und Änderungssteuerung. Er erfindet kein eigenes „KI-Schema“-Vokabular, da keine Plattform ein solches dokumentiert oder verlangt hat, und er empfiehlt nicht, Inhalte auszuzeichnen, die für Nutzende nicht sichtbar sind, denn das verstößt gegen die Richtlinien für strukturierte Daten aller großen Suchmaschinen.
Vokabular, Format und Konsumenten
Schema.org ist das gemeinsame Vokabular, auf dem dieser Leitfaden und praktisch jede gängige Implementierung strukturierter Daten aufbaut: ein gemeinschaftlich gepflegter Satz von Typen und Eigenschaften, der Entitäten und ihre Beziehungen standardisiert beschreibt, sodass Suchmaschinen und andere Konsumenten ihn auswerten können (Schema.org-Dokumentation (öffnet in einem neuen Tab), geprüft am 14.09.2026). JSON-LD ist das Format, das kōdōkalabs für die Umsetzung empfiehlt: ein Block strukturierten JSON, der in die Seite eingebettet ist und ihren Inhalt beschreibt. In einem CMS-Template lässt er sich in der Regel einfacher umsetzen und pflegen als die Alternativen RDFa und Microdata, die strukturierte Attribute direkt im HTML-Markup einbetten.
Eine Unterscheidung ist uns wichtig: Vokabular-Validität ist nicht dasselbe wie Eignung für einen Konsumenten. Ein Markup kann syntaktisch gültiges Schema.org-JSON-LD sein und eine Seite dennoch für keine bestimmte Suchfunktion qualifizieren, denn die Eignung hängt von den zusätzlichen Anforderungen des jeweiligen Konsumenten ab, die jede Plattform separat dokumentiert und die über die reine Vokabular-Validität hinausgehen. Und selbst die Eignung für einen Konsumenten garantiert kein sichtbares Ergebnis: Eine Seite kann für eine Funktion voll geeignet sein und trotzdem nicht für die Anzeige ausgewählt werden, aus Gründen, die die Plattform nicht offenlegt.
| Ebene | Was sie bestätigt | Was sie nicht bestätigt |
|---|---|---|
| Vokabular-Validität | Das Markup ist syntaktisch korrektes Schema.org-JSON-LD und lässt sich fehlerfrei auswerten | Ob irgendeine Plattform es nutzt, anzeigt oder darauf reagiert |
| Eignung für Konsumenten | Die Seite erfüllt die dokumentierten Zusatzanforderungen einer Plattform für eine bestimmte Funktion (etwa die FAQPage-Richtlinien von Google) | Ob diese Funktion für eine bestimmte Nutzerin oder Anfrage tatsächlich angezeigt wird |
| Mögliches sichtbares Ergebnis | Ein Rich Result, eine Zitierung in einer generierten Antwort oder eine andere Funktion kann erscheinen | Nichts garantiert es. Plattformen wählen Funktionen nach nicht offengelegten Kriterien aus |
Entwurf des Entitätsgraphen
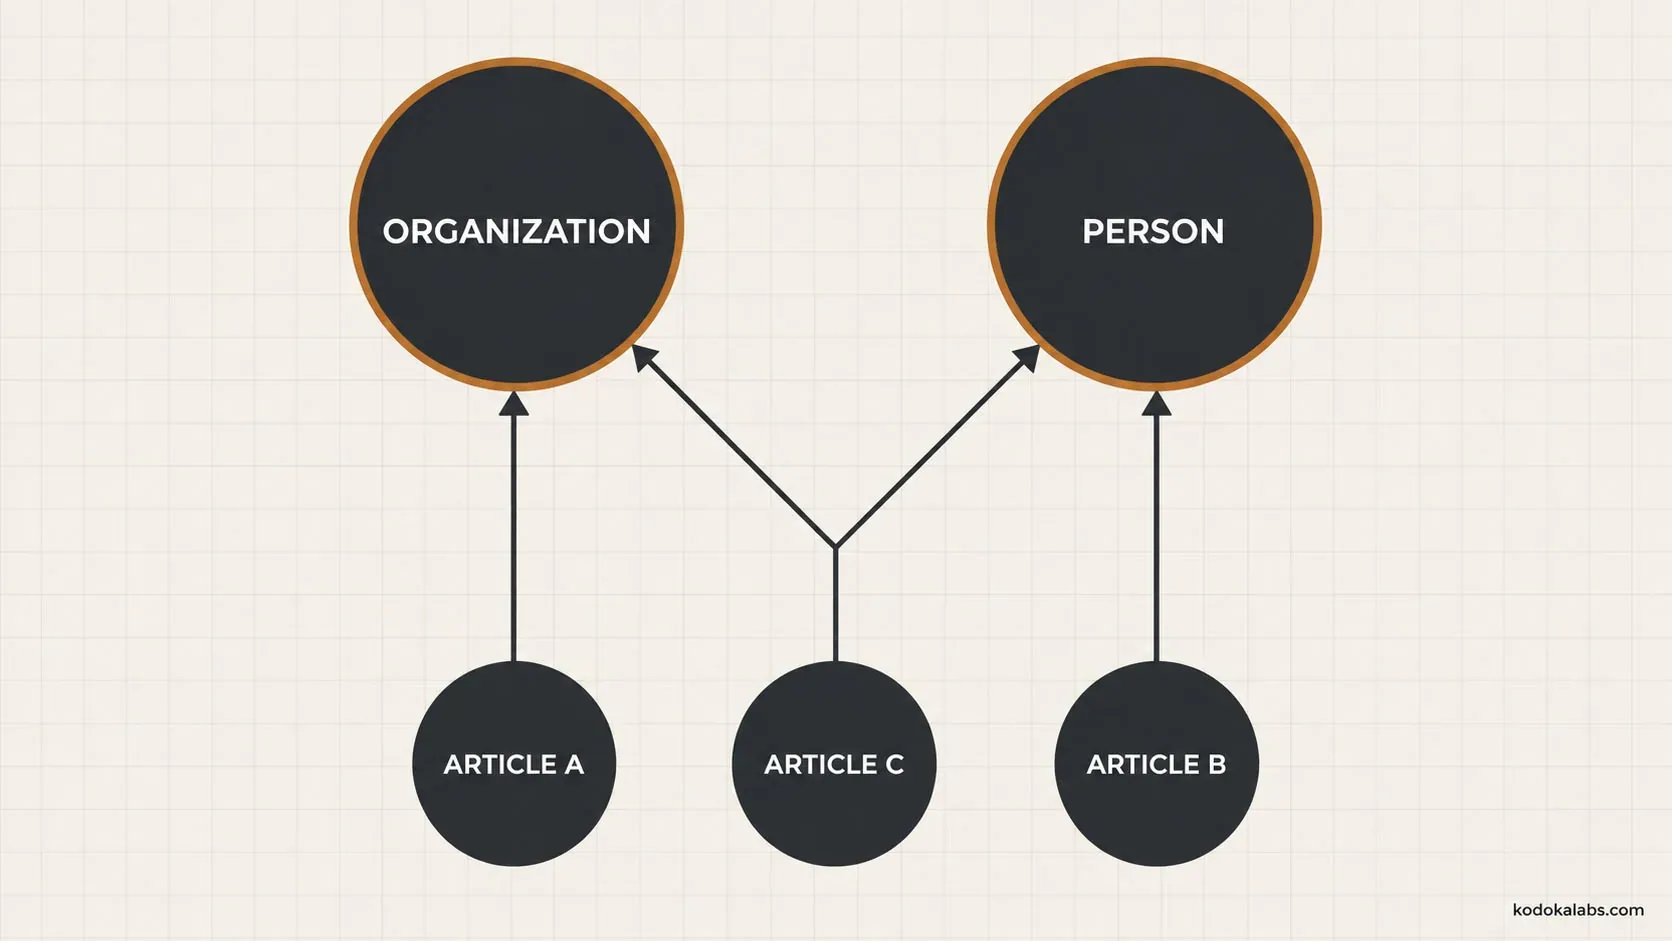
Gut entworfene strukturierte Daten verhalten sich über eine ganze Website hinweg wie ein verbundener Graph, nicht wie eine Sammlung isolierter, seitenweiser Angaben. Der zentrale Mechanismus dafür ist die Eigenschaft @id: Sie vergeben einer Entität (einer Organisation, einer Person, einem bestimmten Inhalt) eine stabile, einheitliche Kennung und verwenden dieselbe @id überall dort wieder, wo die Entität in den strukturierten Daten der Website vorkommt. So kann ein auswertendes System Verweise auf dieselbe Entität über mehrere Seiten hinweg auflösen, statt das Markup jeder Seite als Beschreibung einer fremden, unverbundenen Entität zu behandeln.
Eigenschaften wie mainEntity, about und mentions drücken unterschiedlich starke Beziehungen zwischen einer Seite und einer Entität aus. mainEntity bezeichnet die Entität, um die es auf der Seite im Kern geht. about bezeichnet ein Thema, das die Seite substanziell behandelt, ohne dass es das einzige Hauptthema sein muss. mentions bezeichnet einen echten, aber nachrangigen Bezug, eine Entität, die im Inhalt bedeutsam vorkommt, ohne zentrales Thema zu sein. Wer diese Eigenschaften präzise einsetzt, statt jeden Entitätsbezug pauschal als mainEntity zu markieren, hält den Graphen korrekt und bläht ihn nicht auf.
sameAs verlangt besondere Sorgfalt, weil es sich leicht falsch einsetzen lässt. Die Eigenschaft sollte nur auf wirklich gleichwertige Identitätsdarstellungen derselben Entität an anderer Stelle verweisen, etwa ein verifiziertes offizielles Social-Media-Profil oder einen maßgeblichen externen Eintrag, geprüft zum Zeitpunkt der Umsetzung, da sich externe Seiten ändern können. Auf eine lediglich verwandte oder thematisch ähnliche Seite sollte sie nie verweisen: Das erzeugt eine falsche Identitätsaussage und keinen hilfreichen Querverweis.
Muster je Seitentyp
Unterschiedliche Seitentypen im Intelligence Hub verlangen unterschiedliche primäre Muster für strukturierte Daten, im Einklang mit den Seitenrollen aus der Semantic Content Architecture.
| Seitentyp | Primärer Knoten | Verknüpfte Knoten | Quellfelder | Verantwortlich |
|---|---|---|---|---|
| Cornerstone-Leitfaden (Seiten dieses Pillars) | Article |
BreadcrumbList, Organization (Herausgeber), Person (Autorenschaft, wo zutreffend, über stabile @id) |
Titel, Beschreibung, Autorenschaft, Veröffentlichungs- und Änderungsdatum, Hauptinhalt | Content-Verantwortliche |
| Pillar-Seite | WebPage oder CreativeWork |
BreadcrumbList, verknüpfte untergeordnete Article-Entitäten, wo sinnvoll |
Titel, Beschreibung, aufgeführte untergeordnete Leitfäden | Content-Verantwortliche |
| Gründer-/Über-uns-Seiten | Person, Organization |
sameAs (nur verifizierte externe Profile), WebSite |
Verifizierte Fakten aus dem internen Dokument zu Unternehmens- und Gründerfakten | Content-Verantwortliche, Leitung Technical SEO |
| Lösungs-/Service-Seiten | Service |
Organization (Anbieter), BreadcrumbList |
Servicename, Beschreibung, Anbieter | Content-Verantwortliche |
| FAQ-Abschnitte innerhalb eines Leitfadens (wo tatsächlich vorhanden) | FAQPage |
Frage-Antwort-Paare, die nur dem sichtbaren Seiteninhalt entsprechen | Exakter sichtbarer Text von Frage und Antwort | Content-Verantwortliche, vor dem Rollout mit Eignungsprüfung |
FAQPage- und HowTo-Markup setzen Sie nur ein, wenn die Seite tatsächlich den sichtbaren Inhalt enthält, den diese Typen verlangen: Jede ausgezeichnete Frage und Antwort bzw. jeder ausgezeichnete Schritt muss auf der Seite sichtbar sein. Außerdem muss die Umsetzung zum Zeitpunkt des Rollouts nach den aktuellen Richtlinien der Suchmaschinen weiterhin angemessen sein, denn die Eignungsregeln für diese Typen haben sich schon früher geändert und können sich wieder ändern.
Umsetzung in WordPress
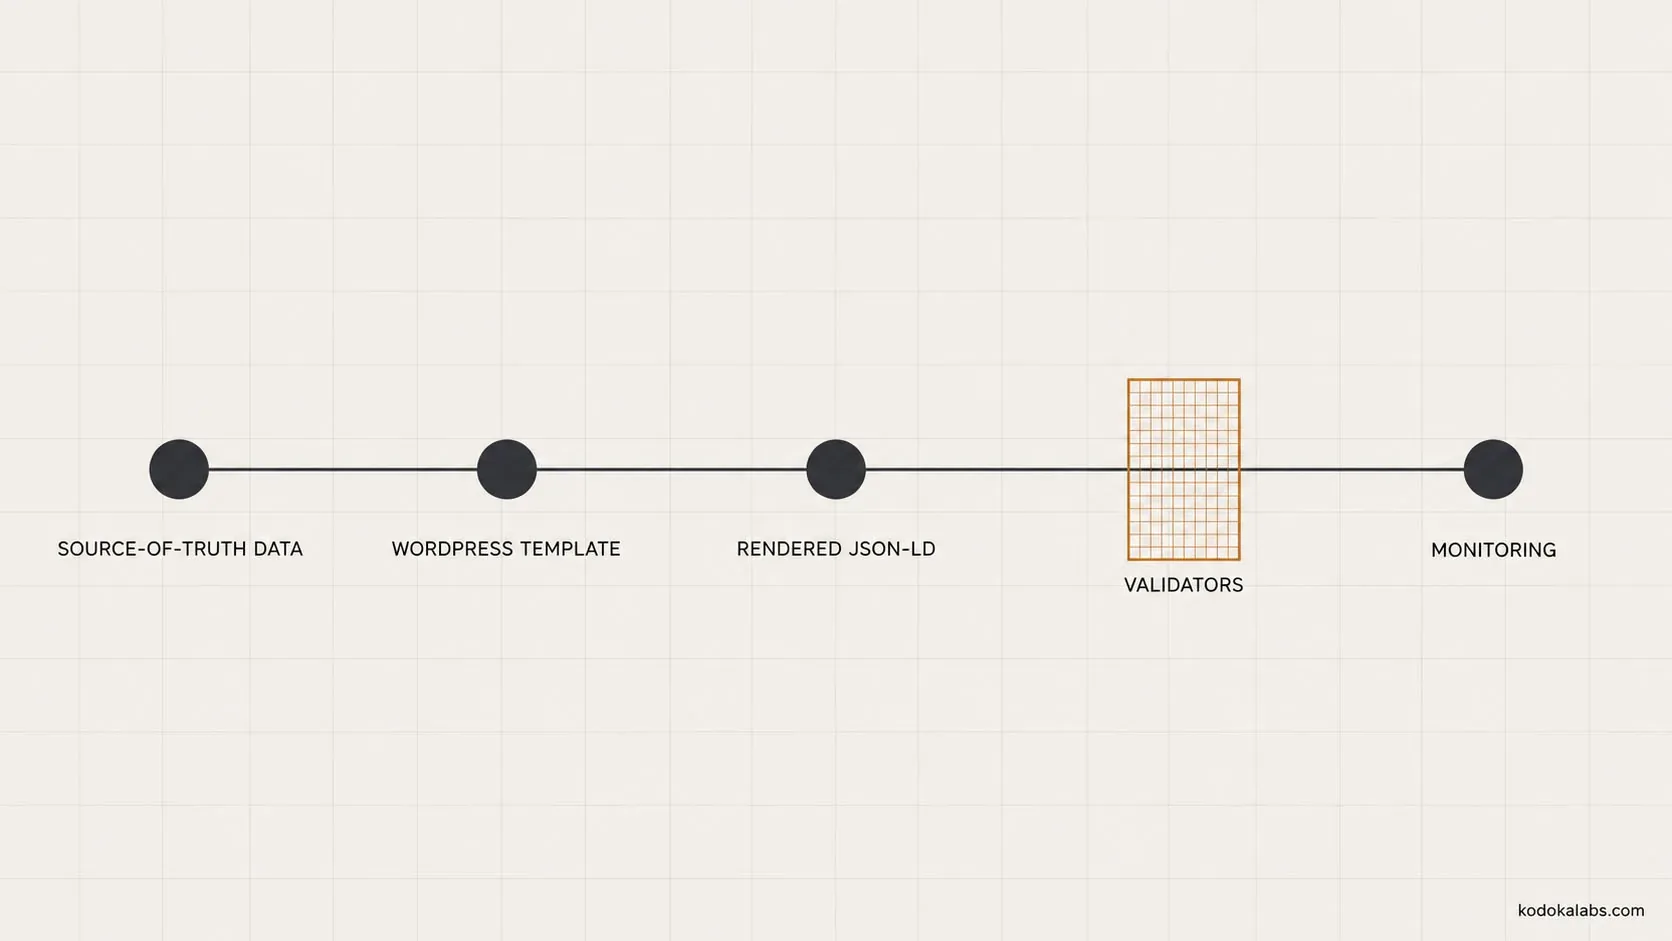
Bei einer WordPress-basierten Umsetzung sollten strukturierte Daten aus den Quell-Inhalten und Entitätsdaten (Source of Truth) erzeugt und nicht auf jeder Seite einzeln von Hand geschrieben werden. So vermeiden Sie das Auseinanderdriften und die Dopplungen, die in den Leitfäden dieses Pillars zu Entitäten und Knowledge Graphs beschrieben sind. Bei einem Template-gesteuerten Ansatz wird das JSON-LD eines Seitentyps automatisch aus den tatsächlichen Feldern der Seite erzeugt (Titel, Autorenschaft, Datum, verknüpfte Entitäten). Das Markup bleibt damit konstruktionsbedingt synchron mit dem sichtbaren Inhalt, ohne dass bei jeder Inhaltsänderung ein manuelles Update nötig ist.
Gibt es ein Entitätsregister der Website (behandelt unter Knowledge Graphs), sollten die WordPress-Schema-Templates @id-Werte und Entitätsdaten aus diesem Register beziehen, statt Entitätsfakten in der Schema-Ebene doppelt zu pflegen. Eine einzige Korrektur im Register wirkt dann automatisch auf die strukturierten Daten jeder Seite, die diese Entität referenziert.
Validierung und Monitoring: das dreistufige Validierungsmodell
Strukturierte Daten zu validieren heißt, drei verschiedene Dinge zu prüfen und nicht nur eines, entsprechend den zuvor beschriebenen Ebenen Vokabular, Konsument und Ergebnis.
Die Syntax- und Vokabular-Validierung bestätigt, dass das JSON-LD syntaktisch korrekt ist und gültige Schema.org-Typen und -Eigenschaften verwendet. Das ist eine mechanische Prüfung, die über ein Schema-Validierungs-Tool (auf Englisch) läuft und fester Bestandteil jedes Inhalts- oder Template-Rollouts sein sollte, keine einmalige manuelle Kontrolle.
Die Validierung der Eignung für Konsumenten bestätigt, dass das Markup über die reine Vokabular-Validität hinaus die dokumentierten Zusatzanforderungen einer Plattform für eine bestimmte Funktion erfüllt. Geprüft wird gegen deren aktuelle, datierte Vorgaben und nicht in der Annahme, sie blieben unbegrenzt stabil.
Die Validierung von Faktentreue und Übereinstimmung mit dem sichtbaren Inhalt bestätigt, dass das Markup korrekt wiedergibt, was auf der Seite tatsächlich sichtbar ist: Jede Entität, jeder Fakt, jede Frage und jede Antwort aus den strukturierten Daten kommt der Sache nach im gerenderten Inhalt vor, den Lesende sehen. Diese Prüfung wird in einer automatisierten Pipeline am ehesten übersprungen, weil sie eine redaktionelle und nicht nur eine technische Prüfung erfordert. Sie hängt am engsten damit zusammen, eine irreführende oder gegen Richtlinien verstoßende Umsetzung zu vermeiden.
Governance und typische Fehlerbilder
Strukturierte Daten brauchen dieselbe Art von Governance-Vertrag wie jedes andere Entitäts- oder Inhaltssystem in diesem Pillar. kōdōkalabs nutzt einen Schema Governance Contract, der für jeden Schema-Knoten festhält: eine zugewiesene Verantwortung, die Source of Truth, die Seiten oder Templates, auf die er sich bezieht, die erforderlichen sichtbaren Felder, die stabile @id, die konkreten Konsumenten-Anforderungen, die er erfüllen soll, den Validierungstest zur Bestätigung, die Verantwortung für den Rollout, einen Monitoring-Bericht zum aktuellen Status und einen definierten Auslöser, wann er überprüft werden muss.
Das häufigste Fehlerbild ist, den Schema-Rollout als einmaliges technisches Projekt zu behandeln und nicht als dauerhafte Governance-Aufgabe. Das Markup driftet dann bei jeder Seitenänderung weiter vom Inhalt weg und beschreibt irgendwann Inhalte, die nicht mehr mit dem sichtbar Vorhandenen übereinstimmen. Das riskiert verschwendeten Umsetzungsaufwand und, in ernsteren Fällen, einen Richtlinienverstoß. Ein zweites häufiges Fehlerbild ist, Typen oder Eigenschaften zu erfinden, die im tatsächlichen Schema.org-Vokabular nicht vorkommen, um KI-Systemen gezielt etwas zu signalisieren. Ein solches Sondervokabular gibt es nicht. Es erzeugt ungültiges Markup, das auswertende Systeme vermutlich ignorieren oder, schlimmer, als Spam-Signal werten.
 KI-generiert Bild
 KI-generiert Bild
Beispiele
Ein durchgespieltes Beispiel ohne Code: Das Article-Markup der Framework-Seite sollte einen Organization-Knoten für kōdōkalabs und einen Person-Knoten für Ben Moll referenzieren, mit denselben stabilen @id-Werten wie auf den Seiten Über uns und Gründer. Ein System, das das Schema der Framework-Seite auflöst, erkennt dann denselben Herausgeber und dieselbe Autorenschaft wie an anderer Stelle der Website und behandelt das Markup nicht jeder Seite als Beschreibung einer fremden Organisation oder Person. Ob Crawler dieses Markup überhaupt erreichen und auslesen können, behandelt Zugänglichkeit für KI-Crawler.
Häufig gestellte Fragen
Garantiert FAQPage-Schema, dass Ihre FAQ als Rich Result erscheint?
Nein. Es macht die Seite für diese Funktion geeignet, sofern alle übrigen Anforderungen erfüllt sind und der sichtbare Inhalt den ausgezeichneten Fragen und Antworten tatsächlich entspricht. Ob Google oder eine andere Plattform die Funktion wirklich anzeigt, ist nicht garantiert und hängt von Kriterien ab, die die Plattform nicht vollständig offenlegt.
Gibt es einen speziellen Schema-Typ für Sichtbarkeit in der KI-Suche?
Nein. Keine große Plattform hat ein KI-spezifisches Schema-Vokabular veröffentlicht oder verlangt. Standardtypen aus Schema.org, korrekt und präzise angewendet, sind derzeit der einzige dokumentierte Weg.
Darf man Inhalte auszeichnen, die auf der Seite nicht sichtbar sind, um KI-Systemen mehr Kontext zu geben?
Nein. Die Richtlinien für strukturierte Daten aller großen Suchmaschinen verlangen, dass das Markup sichtbare Inhalte beschreibt. Das Auszeichnen nicht sichtbarer Inhalte riskiert einen Richtlinienverstoß und untergräbt die Glaubwürdigkeit des Markups, das tatsächlich korrekt ist.
Wie unterscheidet sich sameAs von einem normalen Link?
sameAs von einem normalen Link?sameAs macht eine Identitätsaussage: Die verlinkte Seite repräsentiert dieselbe Entität und nicht bloß eine verwandte. Nutzen Sie es nur für wirklich gleichwertige Identitätsseiten, etwa ein verifiziertes Social-Media-Profil, geprüft zum Zeitpunkt der Umsetzung.
Braucht man für die Umsetzung Entwicklungskapazität, oder kann das Content-Team das selbst?
Beide Rollen zählen: Das Content-Team liefert und pflegt korrekte Quelldaten (gemäß Entitätsregister und kanonischen Fakten), während die Entwicklung die Template-gesteuerte Erzeugung umsetzt, die das Markup mit dieser Quelle synchron hält, wie im Abschnitt „Umsetzung in WordPress“ oben beschrieben.
Wie oft sollten Sie Ihr Schema überprüfen?
Zu den Auslösern, die im Schema Governance Contract festgelegt sind, mindestens immer dann, wenn sich die zugrunde liegenden Entitätsfakten ändern, sowie regelmäßig, um die fortlaufende Konformität mit den sich entwickelnden Plattform-Richtlinien für funktionsspezifisches Markup wie FAQPage zu prüfen.
Kontextbezogene Lösungswege
Ersetzen Sie fragmentiertes Markup auf Seitenebene durch eine gesteuerte Schema-Ebene, die an kanonisches Wissen gebunden ist, im Rahmen eines vollständigen Projekts mit dem AI Marketing Operating System.